Migrer de Make ou Zapier vers n8n : méthode, coûts et pièges (2026)
Migrer de Make ou Zapier vers n8n : méthode en 5 étapes, équivalences, pièges à éviter et budget rée...

Trier ses emails avec l'IA est un excellent moyen de libérer une boîte partagée, mais pas un réglage qu'on active une fois pour toutes : sans liste de catégories claire, seuil de confiance et file de validation humaine, l'équipe finit par revenir au tri manuel.
La scène est la même dans beaucoup de PME. Une adresse contact@ reçoit pêle-mêle des demandes de devis, des factures fournisseurs, des relances, des candidatures, des questions de clients et une bonne dose de prospection non sollicitée. Quelqu'un ouvre chaque message, devine de quoi il parle, le transfère à la bonne personne, puis recommence. Ça prend du temps, et le jour où cette personne est absente, les demandes urgentes dorment.
L'IA sait lire un email, en comprendre l'intention et le router. La vraie question, c'est à quel niveau l'utiliser, comment le brancher sans perdre le contrôle, et à quel prix. C'est ce qu'on détaille ici, étape par étape, avec la méthode qu'on applique sur nos projets d'automatisation n8n.
Pour trier ses mails avec l'IA, on branche un workflow n8n sur la boîte partagée : il lit chaque email, le classe dans une catégorie définie à l'avance grâce à un modèle de langage, extrait les informations utiles (client, montant, échéance) et le route vers la bonne personne ou le bon outil. Tout ce que le modèle classe avec une confiance insuffisante part dans une file de revue humaine. CZ Multimédia facture un workflow simple à base de règles 800 à 2 000 € HT et un workflow IA complet 3 000 à 8 000 € HT, plus 20 à 60 €/mois d'hébergement self-hosted et quelques dizaines d'euros d'API LLM.
Pour un cadrage sur ton projet : Contactez-nous
Il existe trois niveaux pour trier une boîte partagée — des règles, un modèle de classification, un agent IA — et la bonne architecture les empile dans cet ordre au lieu de choisir le plus puissant. Chaque niveau traite ce que le précédent ne sait pas faire, et chacun coûte plus cher, à construire comme à faire tourner.
Une règle décide à partir de signaux structurés : expéditeur, domaine, objet, pièce jointe. « Tout ce qui vient de tel fournisseur avec un PDF va dans Factures. » C'est gratuit à l'exécution, instantané et parfaitement prévisible.
La limite apparaît dès que l'intention est dans le texte. « Pouvez-vous me renvoyer le document ? » peut être une demande de devis, une relance de facture ou une question de support : aucun mot-clé ne tranche.
Un modèle de langage lit l'objet et le corps du message, et répond par une catégorie choisie dans une liste fermée. Il comprend la paraphrase, la faute de frappe, le message rédigé dans une autre langue, le client qui mélange deux sujets. C'est le cœur d'un tri d'emails par IA, et pour la majorité des boîtes partagées, c'est suffisant.
Ce niveau reste un workflow : le parcours est fixe (lire, classer, extraire, router), seule la décision de classement est confiée au modèle. Il est donc testable, mesurable et prévisible dans sa structure.
Un agent dispose d'outils et décide lui-même de les utiliser : ouvrir la pièce jointe, chercher l'expéditeur dans le CRM, consulter le dossier client. Il se justifie quand l'email seul ne suffit pas pour décider.
Il coûte plus cher, se teste plus difficilement et demande davantage de garde-fous. On ne commence jamais par lui.
| Niveau | Décide à partir de | Bon pour | Limite |
|---|---|---|---|
| Règles | Expéditeur, objet, domaine, pièce jointe | Factures de fournisseurs connus, notifications, newsletters | Aveugle à l'intention |
| IA de classification | Le texte du message | Demandes clients, devis, support, candidatures | Ne voit que l'email |
| Agent IA | Le message + des outils (CRM, pièces jointes, dossier) | Cas ambigus qui exigent un contexte externe | Coût, tests, garde-fous |
On a documenté deux projets de ce type, et ils disent la même chose. Dans notre guide pratique de l'agent IA avec n8n, un cabinet comptable a d'abord eu un workflow à base de règles, qui ne traitait qu'une partie des messages ; l'agent n'est venu qu'ensuite, sur les emails qui restaient, et le workflow initial lui a servi de base. Dans le cas 4 de nos cas clients d'automatisation n8n, un éditeur de logiciel a obtenu un tri et un routage fiables avec une simple couche d'analyse, sans laisser l'IA répondre aux clients. La leçon commune : on empile les niveaux, on ne saute pas directement au plus sophistiqué. Ces deux articles racontent le résultat ; celui-ci détaille la méthode pour y arriver.
On ne vend pas un agent IA pour trier une boîte mail tant qu'un workflow de classification n'a pas été mesuré sur les vrais emails. Dans la plupart des cas, règles + classification couvrent l'essentiel du volume. L'agent ne se justifie que pour le reliquat qui exige d'aller chercher une information ailleurs — et ce reliquat, on ne le connaît qu'après avoir fait tourner le niveau 2.
Un tri automatique ne vaut que ce que vaut sa liste de catégories : avant d'ouvrir n8n, on passe quelques heures à comprendre ce qui arrive réellement dans la boîte et qui doit le traiter. C'est l'étape la plus souvent sautée, et c'est elle qui décide si le projet tiendra.
On exporte plusieurs semaines de la boîte, pour couvrir fins de mois, relances et périodes calmes, et on annote chaque email à la main. Cet échantillon sert deux fois : définir les catégories maintenant, mesurer la qualité du tri plus tard. Sans lui, on saura seulement si personne ne s'est plaint.
Attention à la confidentialité dès cette étape : l'échantillon contient des données personnelles. Il reste sur un espace interne, accessible aux seules personnes du projet, et il est supprimé ou anonymisé une fois le projet livré.
Une bonne catégorie répond à la question « qui fait quoi avec ce message ? », pas « de quoi parle-t-il ? ». « Demande de devis → commercial » est actionnable ; « Question produit » ne l'est pas si trois personnes différentes peuvent la traiter.
Quelques règles qu'on applique :
Classer ne suffit pas : pour qu'un email routé soit traité vite, on extrait les champs dont la personne a besoin. Une demande de devis : nom, société, téléphone, besoin, délai. Une facture fournisseur : fournisseur, numéro, montant, échéance. Une candidature : poste visé, présence d'un CV. On ne liste que ce qui sera utilisé en aval, dans le CRM, le tableur ou la notification : chaque champ extrait inutilement est une donnée personnelle traitée sans raison.
Pour chaque catégorie : où va le message (personne, file, canal, outil métier), sous quel délai il doit être traité, et qui reprend en cas d'absence. Cette table, c'est la spécification du workflow. Elle doit être validée par les personnes qui vont recevoir les emails, pas seulement par la direction.
Un tri d'emails par IA dans n8n tient en quatre blocs — lecture, classification, extraction, routage — encadrés par un pré-filtre en règles en amont et un journal en aval. Chaque bloc correspond à des nœuds standards de n8n ; aucun développement exotique n'est nécessaire.
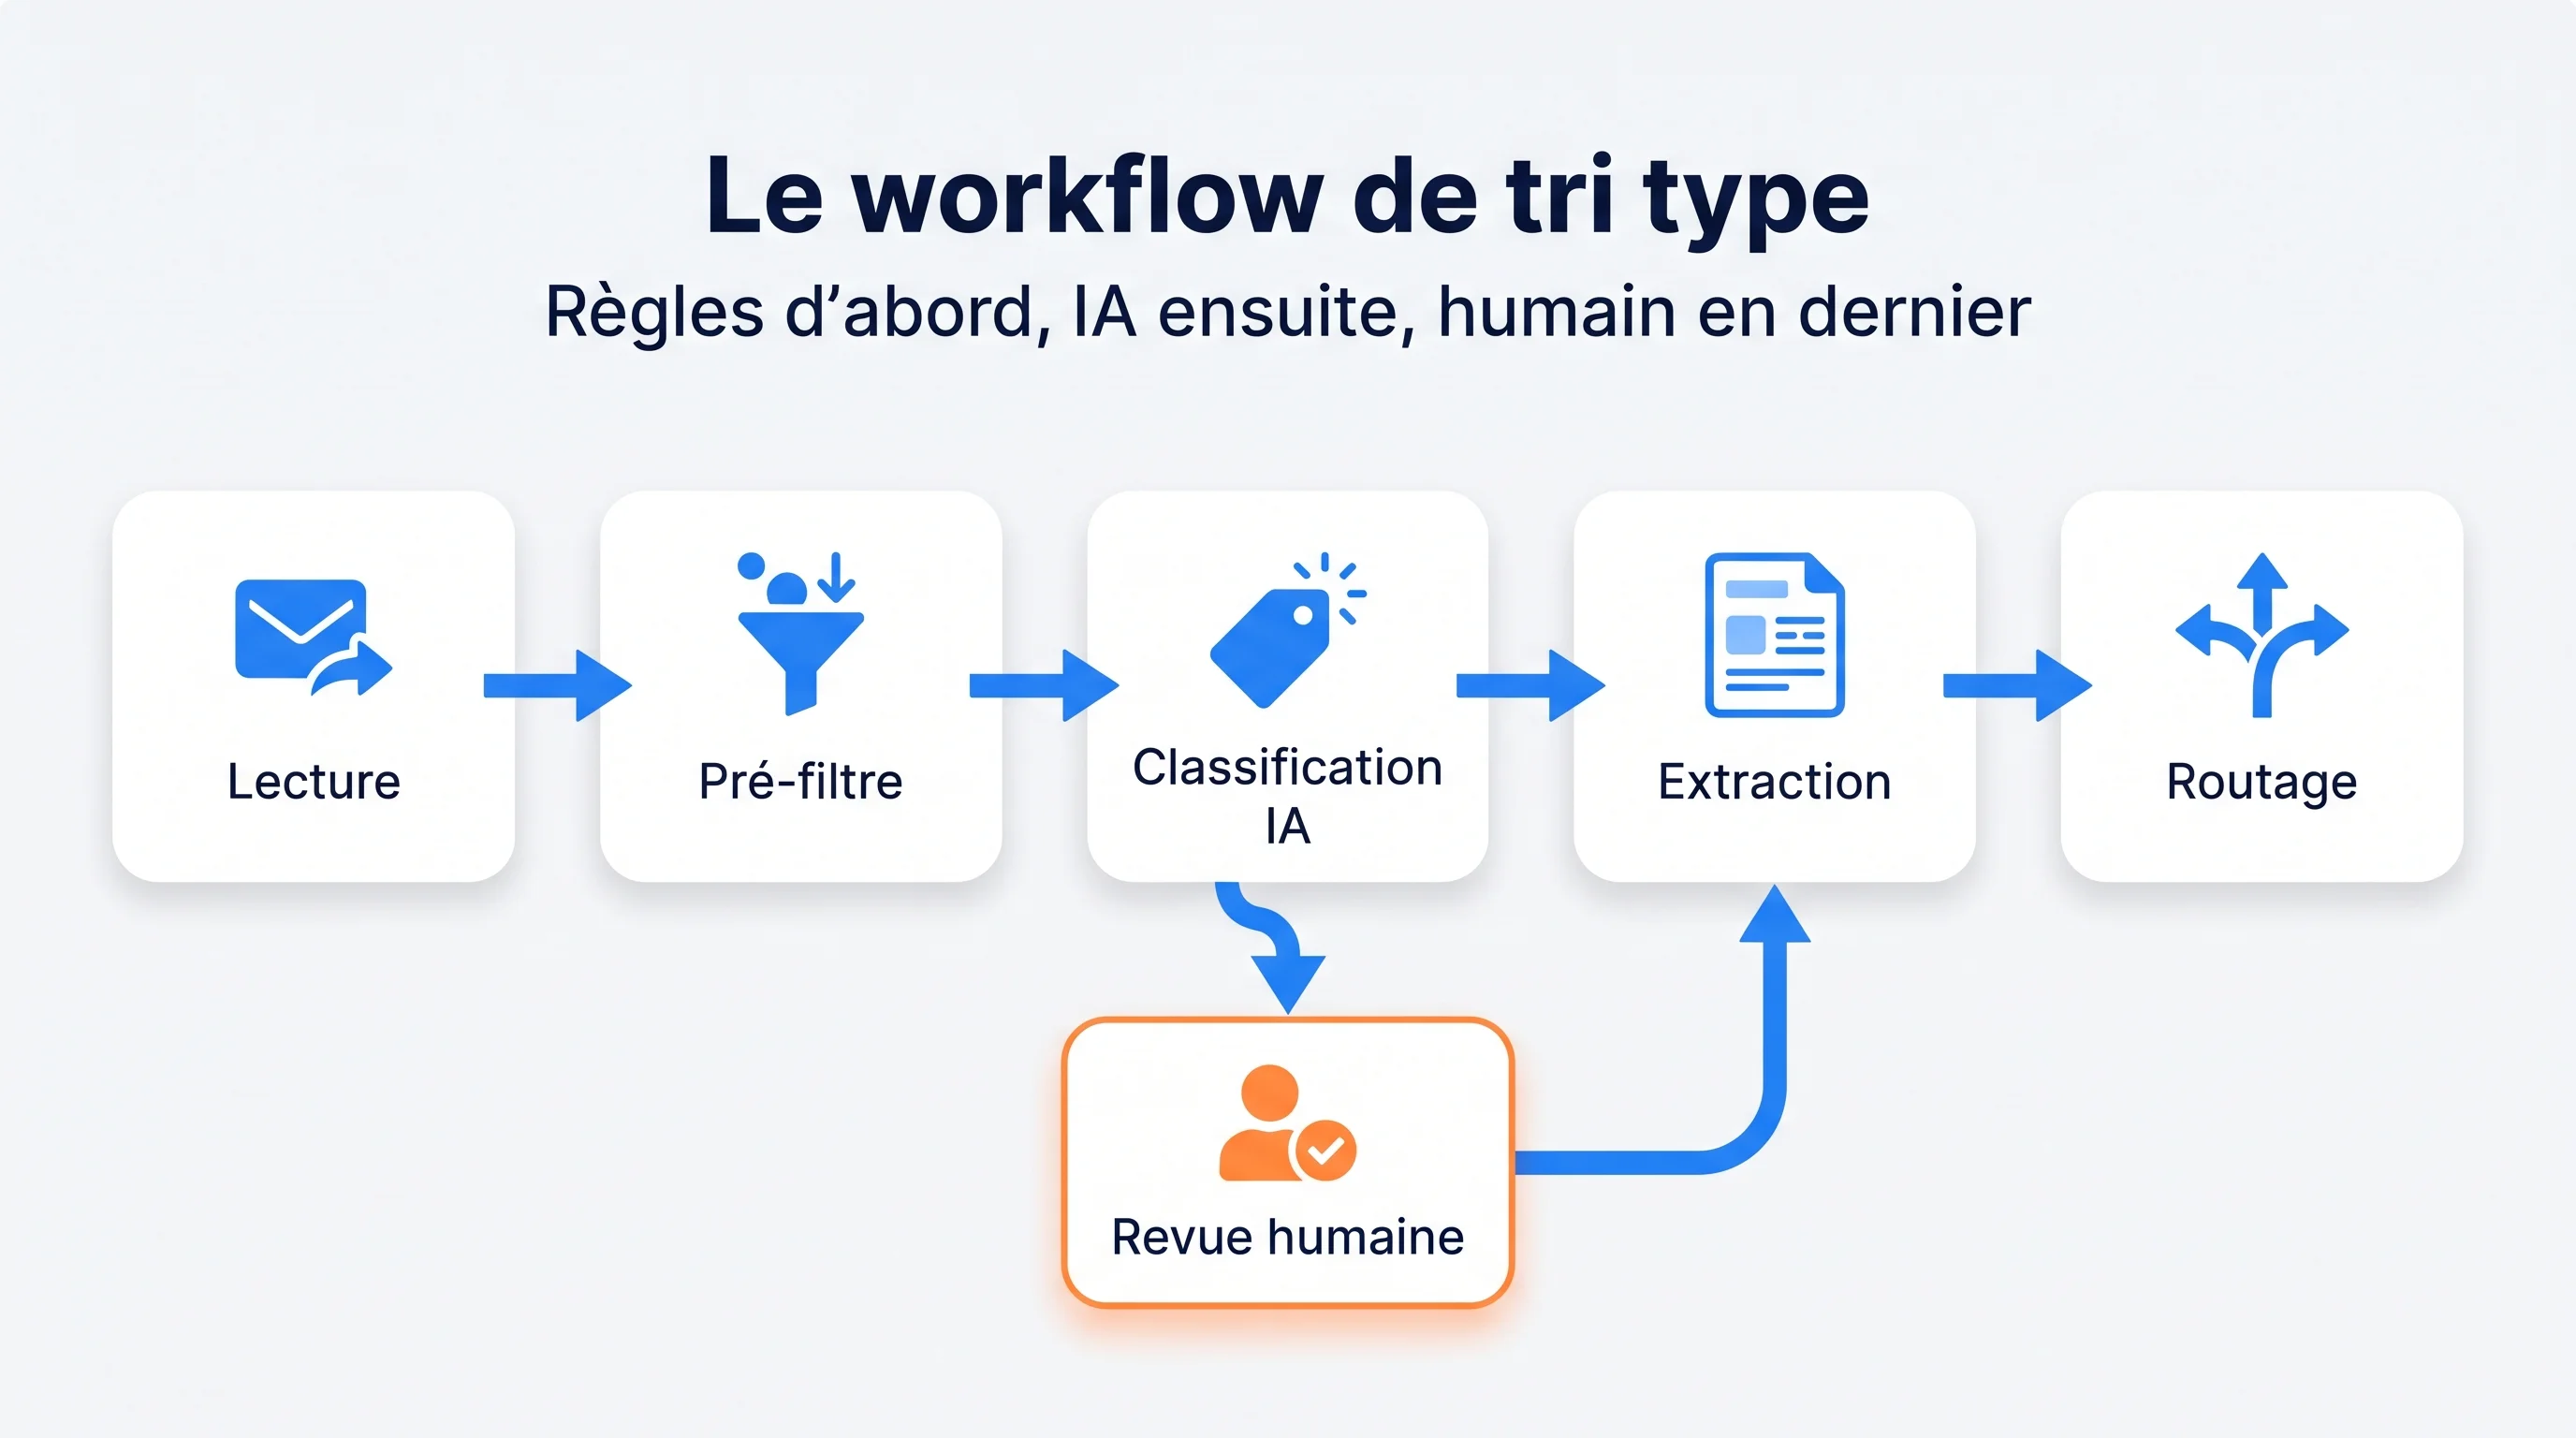
Le workflow démarre sur un déclencheur de messagerie : le nœud Gmail Trigger pour Google Workspace, le déclencheur Microsoft Outlook pour Microsoft 365, ou le déclencheur IMAP générique pour les autres hébergeurs. Il récupère l'expéditeur, l'objet, le corps, et la liste des pièces jointes.
Trois précautions dès ce bloc :
Avant d'appeler le modèle, un nœud Switch applique les règles du niveau 1 : fournisseurs connus, notifications d'outils, newsletters, réponses automatiques d'absence. Ces messages sont classés et routés directement. Ce pré-filtre réduit le coût en API, accélère le traitement, et surtout rend une partie du tri parfaitement prévisible.
Pour la classification, n8n propose un nœud dédié, Text Classifier, qui prend une liste de catégories avec leur description et renvoie la catégorie retenue. On peut aussi passer par un nœud LLM classique avec une sortie structurée en JSON. Dans les deux cas, trois règles :
On demande aussi au modèle un score de confiance et une justification courte. Le score sert au seuil (voir les garde-fous), la justification sert à comprendre les erreurs pendant la phase de rodage.
Une fois la catégorie connue, on extrait les champs prévus pour cette catégorie. Le nœud Information Extractor de n8n fait ce travail à partir d'un schéma : nom du champ, type, description. On extrait après la classification, avec un schéma propre à chaque catégorie, plutôt qu'un schéma géant valable pour tout : le modèle est plus précis, et on n'extrait pas de données inutiles.
Chaque champ extrait est ensuite vérifié par du code déterministe : un email a une forme d'email, un montant est un nombre positif, une date est une date plausible. Un champ obligatoire manquant renvoie le message en revue humaine plutôt que de créer une fiche à moitié vide.
Le routage applique la table de routage : libellé ou dossier dans la boîte partagée, notification dans la messagerie d'équipe, fiche CRM, ligne dans le tableur de suivi des factures. On évite de transférer l'email lui-même, qui duplique les données et casse le fil de la conversation : mieux vaut un libellé et une notification avec un lien.
Chaque email traité laisse une ligne dans un journal : date, identifiant du message, catégorie, score de confiance, chemin emprunté (règle, IA, revue humaine), et correction éventuelle. Ce journal ne contient pas le corps du message, seulement la décision. C'est lui qui permet de mesurer la qualité du tri, de repérer une dérive et d'améliorer les définitions de catégories.
Enfin, un workflow d'erreur (Error Trigger dans n8n) prévient quelqu'un si le tri s'arrête : jeton expiré, API indisponible, quota atteint. Un tri en panne silencieuse est pire que pas de tri, parce que plus personne ne surveille la boîte.
Règles d'abord, IA ensuite, humain en dernier recours. Chaque email emprunte le chemin le moins cher capable de le traiter correctement, et chaque décision laisse une trace dans le journal.
Un tri par IA fiable n'est pas un tri qui ne se trompe jamais, c'est un tri qui sait quand il risque de se tromper et qui passe la main à un humain à ce moment-là. Trois garde-fous rendent ça possible.
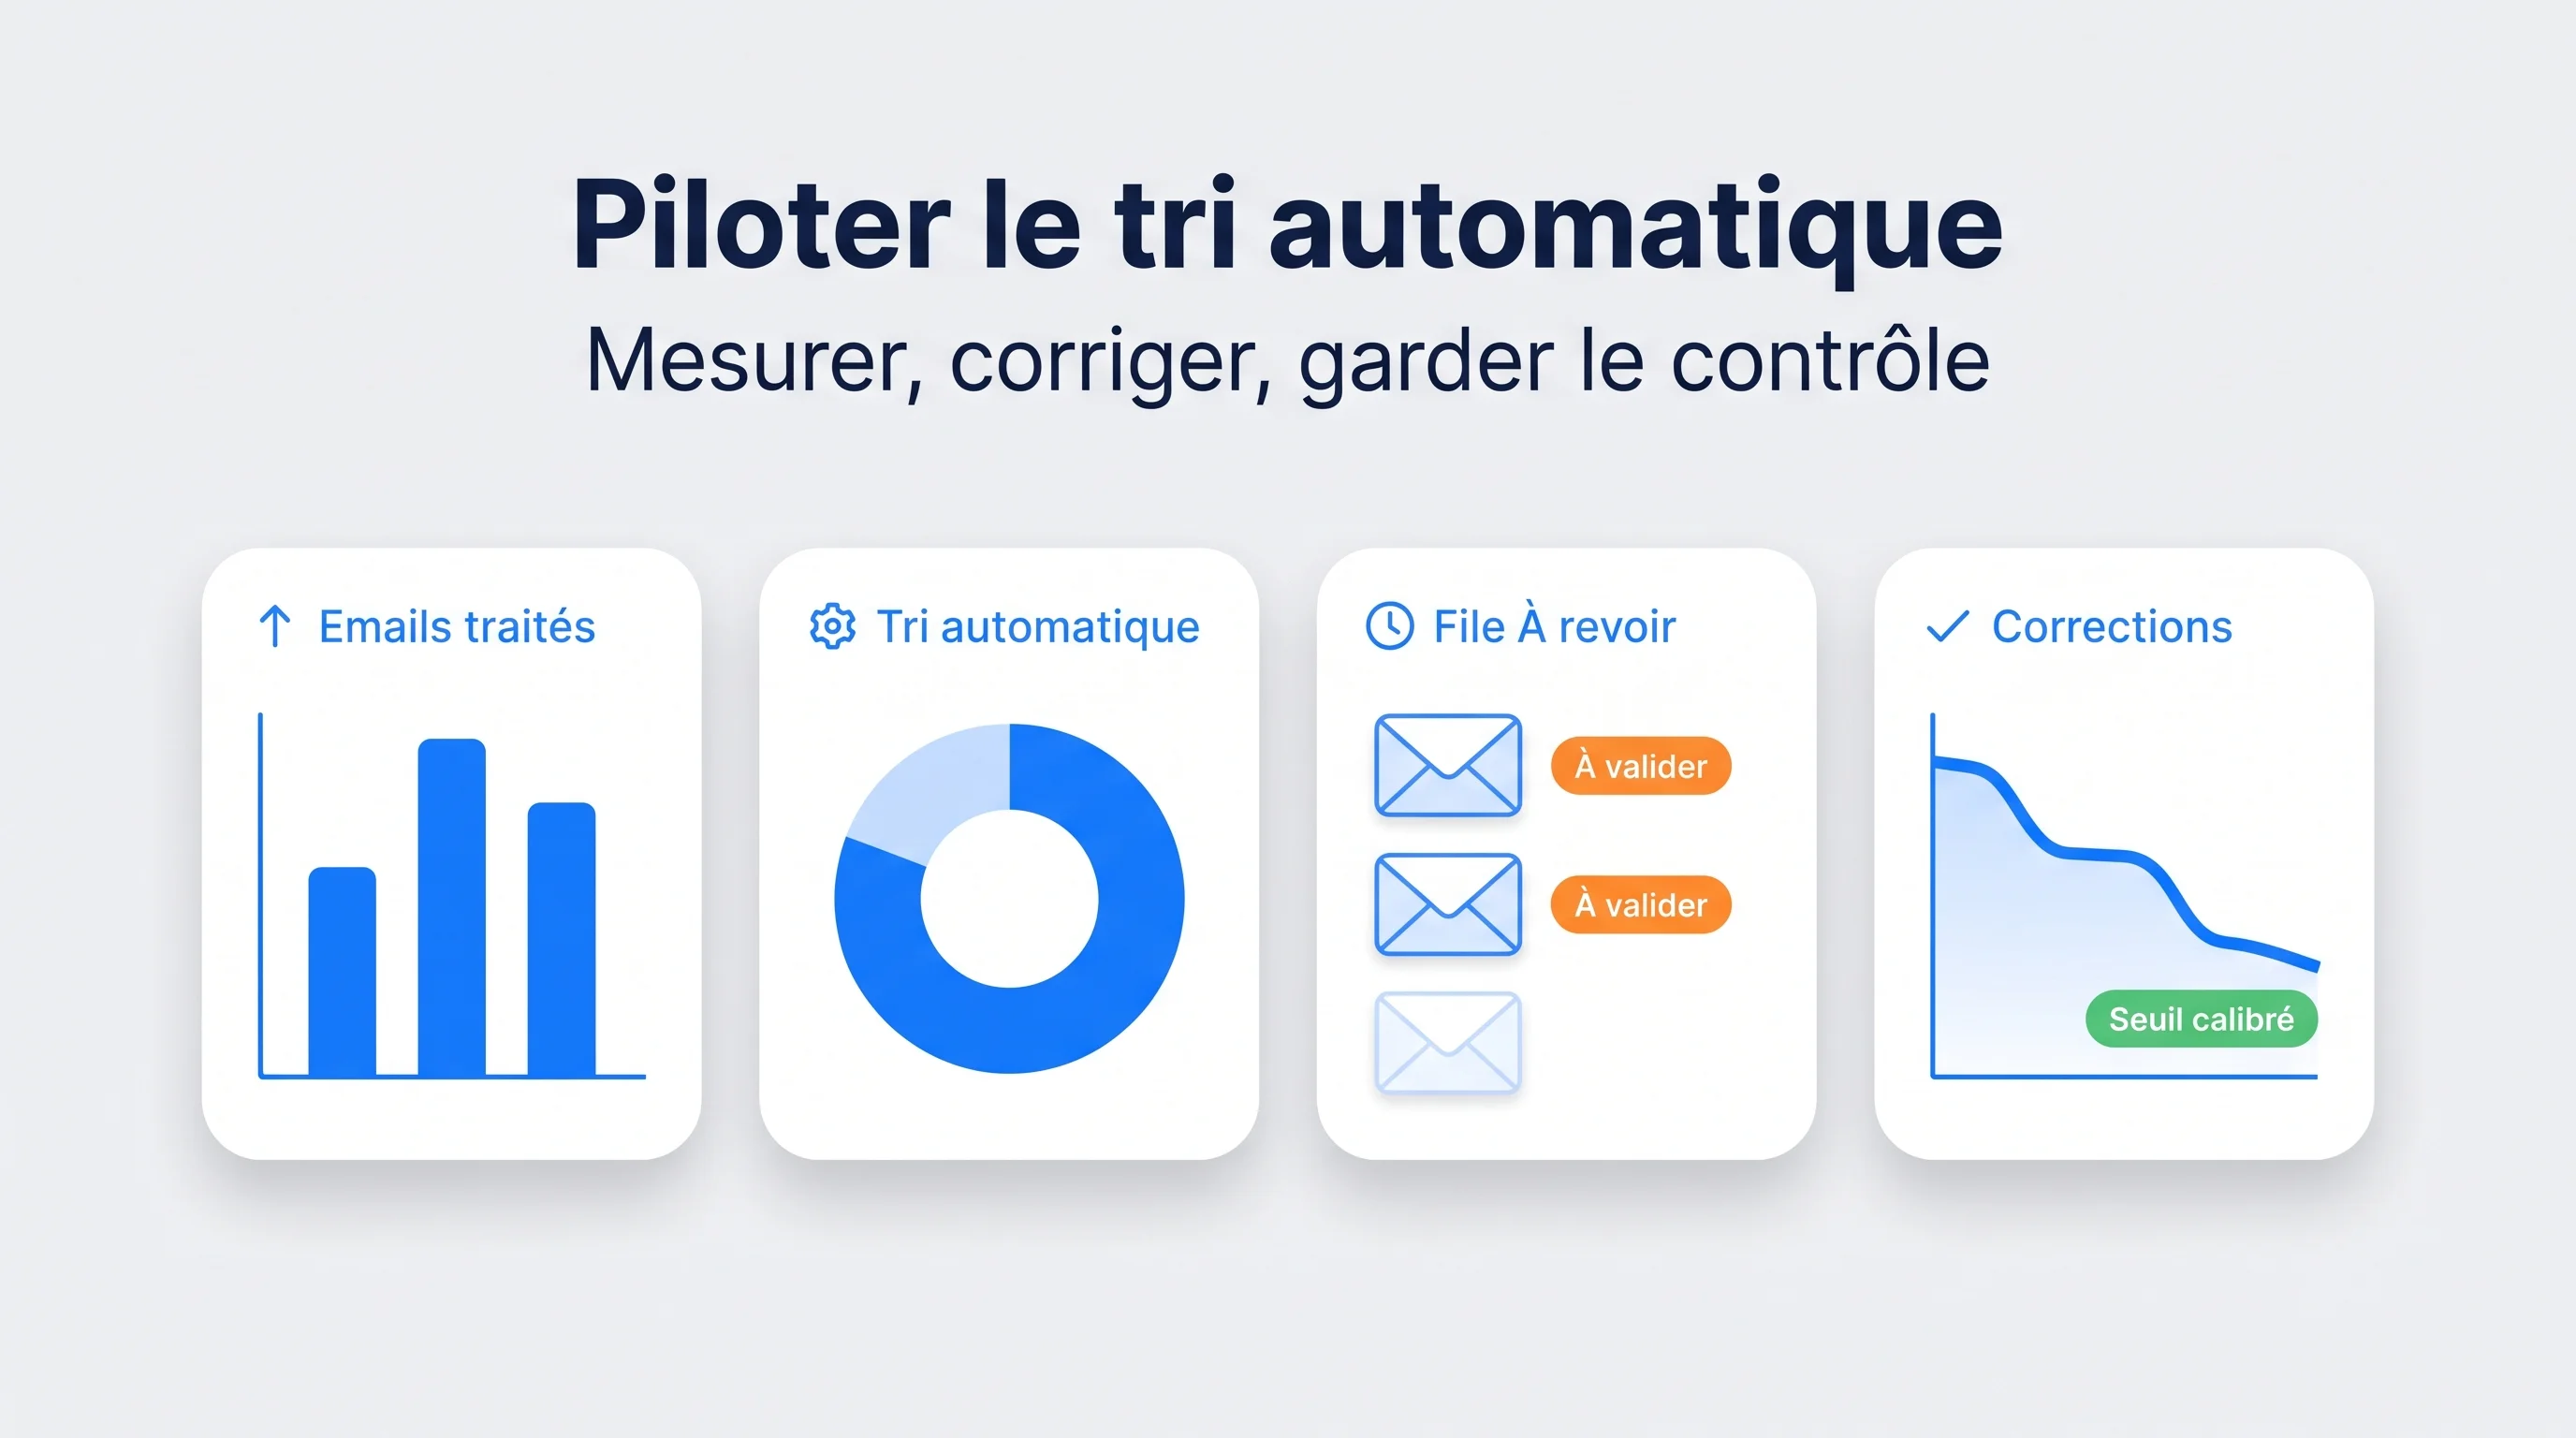
Chaque classification arrive avec un score de confiance. Au-dessus du seuil, l'email est routé automatiquement ; en dessous, il part dans la file « À revoir », traitée par un humain. Deux points à connaître.
Le score déclaré par un modèle de langage n'est pas une probabilité fiable. Un modèle peut se dire très sûr de lui et se tromper. Le seuil ne se fixe donc pas à l'intuition : on le calibre sur l'échantillon annoté de l'étape de cartographie. On fait passer les emails de l'échantillon dans le workflow, on compare les catégories obtenues aux catégories humaines, et on regarde à partir de quel score les erreurs deviennent rares. Le seuil se pose là.
Le seuil peut varier selon la catégorie. Une erreur sur « Indésirable » coûte peu ; une erreur qui envoie une réclamation client dans les newsletters coûte cher. Les catégories sensibles méritent un seuil plus exigeant, voire une revue systématique au démarrage.
La règle qu'on applique : le tri et le routage peuvent tourner seuls, tout ce qui sort de l'entreprise passe par un humain. Ranger un email dans le mauvais dossier se corrige en un clic ; envoyer une réponse erronée à un client ne s'annule pas.
Concrètement :
La validation doit rester rare pour rester sérieuse. Si la file « À revoir » déborde, les catégories sont mal définies ou le seuil est mal calibré.
Une boîte partagée contient des noms, des adresses, des numéros de téléphone, parfois des données sensibles (santé, situation financière). Trier ces emails avec un modèle de langage est un traitement de données personnelles, avec les obligations qui vont avec :
L'hébergement simplifie beaucoup de ces points. Un n8n self-hosted sur un serveur en Europe garde les emails, le journal et les identifiants de messagerie chez toi ; seule la partie classification sort vers l'API du modèle, avec le texte minimisé. Pour aller plus loin, un modèle hébergé dans l'Union européenne supprime aussi cette sortie. C'est l'architecture par défaut de nos projets sur n8n en self-hosted.
Brancher le tri sur la boîte partagée avec le compte personnel du gérant, « parce que c'est plus simple ». Le jour où ce compte change de mot de passe, le tri s'arrête sans prévenir ; le jour où le workflow est mal configuré, il a accès à toute la messagerie du dirigeant. Un compte de service dédié, limité à la boîte partagée, se crée en quelques minutes.
Contactez-nous si tu as un doute sur la façon de brancher l'IA sur ta messagerie sans exposer tes données — on te dit honnêtement ce qui peut tourner seul et ce qui doit rester validé.
Chez CZ Multimédia, un tri d'emails à base de règles coûte 800 à 2 000 € HT, un workflow IA complet (classification, extraction, routage) 3 000 à 8 000 € HT, et un agent IA mono-tâche connecté 4 000 à 12 000 € HT ; le récurrent se compte en dizaines d'euros par mois, hors maintenance. Le bon budget dépend du niveau retenu, pas du volume d'emails.
| Niveau | Ce qui est livré | Fourchette (HT) |
|---|---|---|
| Workflow simple | Règles de tri et de routage, libellés, notifications | 800 – 2 000 € |
| POC / premier chantier | Classification IA sur la boîte, mesurée sur l'échantillon annoté | 2 000 – 4 000 € |
| Workflow IA | Classification + extraction + routage vers CRM ou outils métier, seuil, file de revue, journal | 3 000 – 8 000 € |
| Agent IA mono-tâche connecté | Tri avec outils (pièces jointes, CRM, dossier client) et validation humaine | 4 000 – 12 000 € |
Ce qui fait bouger le prix : le nombre de catégories et de schémas d'extraction, les outils connectés en aval et le niveau de garde-fous exigé. La file de validation humaine et le journal ne sont pas des options : ils font partie du livrable.
Pour donner un ordre de grandeur sur un agent, un agent de tri et de ressaisie qu'on a livré pour une PME industrielle a coûté 6 500 € HT, pour environ 40 heures économisées par mois, et s'est rentabilisé au 8e mois. Le détail des grilles de prix figure dans notre page agence n8n.
| Poste | Ordre de grandeur |
|---|---|
| Hébergement n8n self-hosted (serveur en France) | 20 – 60 €/mois |
| API du modèle de langage | quelques dizaines d'euros par mois pour un usage PME |
| Maintenance | 3 mois inclus après livraison, puis à partir de 200 €/mois |
La facture d'API dépend surtout de deux choix de conception : le pré-filtre en règles (chaque email trié par règle ne coûte rien) et la longueur du texte envoyé au modèle (un corps nettoyé coûte nettement moins qu'un fil de discussion complet avec ses signatures). Les pièces jointes analysées par l'IA, notamment les PDF longs, sont le poste qui peut faire monter la facture.
Trois chiffres suffisent : le temps passé chaque jour à trier, le coût horaire chargé de la personne qui le fait, et la part d'emails traitée sans revue humaine — mesurée sur l'échantillon annoté pendant le POC, pas promise. Le gain réel, c'est le temps de tri initial moins le temps passé sur la file « À revoir ». S'y ajoute un gain difficile à chiffrer : les demandes urgentes ne dorment plus pendant les absences.
La plupart des tris automatiques abandonnés ne l'ont pas été parce que l'IA classait mal, mais parce que l'équipe a cessé de lui faire confiance. Voici les erreurs qu'on retrouve le plus souvent, et la parade à chacune.
Quinze catégories dont trois se recouvrent : le modèle hésite, les humains aussi, et chaque erreur ressemble à un défaut de l'IA alors que c'est un défaut de la liste. Parade : six à dix catégories, chacune avec une définition, un exemple et un contre-exemple, et une seule catégorie possible par email.
Sans porte de sortie, le modèle range chaque message quelque part, y compris quand il ne sait pas. Les erreurs sont silencieuses : l'email est dans le mauvais dossier, personne ne le voit. Il suffit de deux ou trois incidents de ce type pour que l'équipe se remette à vérifier tous les dossiers à la main. Parade : une catégorie « À revoir » et un seuil de confiance calibré.
Sans journal ni suivi, la qualité du tri n'est connue que par les plaintes. Or les boîtes partagées évoluent : un nouveau fournisseur, une nouvelle offre, une campagne de prospection change la nature des messages. Parade : un point hebdomadaire pendant le premier mois, puis mensuel, sur trois indicateurs — part traitée automatiquement, volume de la file « À revoir », corrections humaines par catégorie.
Chaque erreur de classement ajoute une phrase au prompt, jusqu'à ce qu'il devienne illisible et que chaque modification casse autre chose. Parade : corriger les définitions de catégories, rejouer l'échantillon annoté après chaque modification, comme un test de non-régression.
Un accusé de réception générique, envoyé automatiquement, ne pose pas de problème. Une réponse rédigée par l'IA et envoyée sans relecture, si : une erreur sur un délai ou un tarif engage l'entreprise, et la confiance de l'équipe ne s'en remet pas. Parade : brouillon proposé, envoi validé par un humain, au moins les premiers mois.
Le workflow tourne, la file « À revoir » se remplit, et personne n'est désigné pour la traiter. Les emails ambigus — souvent les plus importants — attendent. Parade : un responsable nommé de la file de revue et du suivi des indicateurs, avec un suppléant. Le tri automatique ne supprime pas ce rôle, il le rend plus court.
Si l'essentiel des messages se trie par expéditeur, un workflow IA ajoute du coût sans bénéfice. Parade : analyser l'échantillon d'abord ; si les règles couvrent presque tout, on s'arrête au niveau 1.
Avant de brancher l'IA sur ta boîte partagée, chaque point doit avoir une réponse claire.
Un échantillon de vrais emails couvrant plusieurs semaines a été extrait et annoté à la main
La liste compte six à dix catégories exclusives, chacune avec une définition, un exemple et un contre-exemple
Une catégorie « À revoir » existe, et une personne nommée traite cette file dans un délai défini
La table de routage (catégorie, destination, délai, suppléant) est validée par les personnes qui reçoivent les emails
Un pré-filtre en règles traite les messages évidents avant tout appel au modèle
Le seuil de confiance est calibré sur l'échantillon annoté, avec un seuil plus strict pour les catégories sensibles
Le workflow utilise un compte de service dédié, limité à la boîte partagée
Le texte envoyé au modèle est nettoyé (sans signatures ni historique) et balisé comme donnée, pas comme consigne
Aucune réponse ne part vers l'extérieur sans validation humaine
Le traitement est inscrit au registre RGPD, le fournisseur du modèle est encadré par un contrat, la durée de conservation du journal est fixée
Chaque décision est journalisée, et un workflow d'erreur prévient quelqu'un si le tri s'arrête
Si ta boîte partagée prend chaque jour du temps à quelqu'un de ton équipe, on peut regarder ensemble ce qui peut être trié par règles, ce qui mérite l'IA, et ce qui doit rester humain — avant d'écrire la moindre ligne de workflow.
Contactez-nous — réponse sous 24 h, sans engagement.
J’aide les PME à améliorer leur site web et leurs projets digitaux pour générer plus de demandes clients.
Je vous propose un audit gratuit, rapide et sans engagement.
Sans engagement • Recommandations concrètes • Réponse sous 24h
Migrer de Make ou Zapier vers n8n : méthode en 5 étapes, équivalences, pièges à éviter et budget rée...

5 cas clients réels d'automatisation n8n : devis, relances, reporting, support. Méthode, coûts et ga...
Un chatbot répond, un agent agit. Budget de 1 à 10, risques, 6 cas d'usage PME et grille de décision...
7 cas d'usage d'agent IA en entreprise avec budget réel : tri de documents, qualification, RAG, repo...
Un agent IA n8n choisit lui-même ses outils. Architecture, briques nécessaires, garde-fous, coûts ré...
La gestion des bases de données a longtemps été réservée aux développeurs et aux spécialistes SQL\. ...