GEO : optimiser son site pour ChatGPT, Perplexity et les moteurs IA
GEO : la nouvelle discipline qui optimise ton site pour être cité par ChatGPT, Perplexity, Gemini. 7...

Le trafic venant de ChatGPT et des assistants IA se mesure — mais jamais avec un seul outil : GA4 voit les visites humaines, les logs serveur ce qui atteint ton origine, Cloudflare tout ce qui touche le réseau, et aucun des trois ne dit seul si ce trafic t'apporte des clients.
La question arrive désormais en réunion : « Est-ce que ChatGPT nous envoie du monde ? » On ouvre Google Analytics, on trouve quelques sessions perdues dans « Referral », et on conclut que le sujet n'existe pas. Pendant ce temps, les journaux serveur voient passer des requêtes signées GPTBot ou ClaudeBot, dont une partie n'a rien à voir avec l'IA. Nous avons vécu ce flou sur notre propre site en septembre 2026 ; voici la méthode que nous en avons tirée.
Pour mesurer le trafic de ChatGPT dans Google Analytics 4, crée un groupe de canaux personnalisé « Assistants IA » qui classe par regex les sources chatgpt.com, perplexity.ai, gemini.google.com, copilot.microsoft.com, claude.ai et mistral.ai, placé avant « Referral ». Ajoute une attribution first-touch pour relier ces visites aux leads, puis compte les crawlers IA dans tes logs ou chez Cloudflare, en écartant les faux robots.
Pour mettre en place cette mesure sur ton site : Contactez-nous
Deux problèmes se superposent : les visites humaines venues d'un assistant perdent souvent leur provenance en route, et les robots IA forment trois familles aux rôles très différents que les outils mélangent.
GA4 attribue une visite grâce à deux indices : le referrer transmis par le navigateur et les paramètres UTM de l'URL. Sans l'un ni l'autre, la visite part en Direct. Or les assistants cumulent les cas où le referrer disparaît : applications mobiles et navigateurs intégrés qui ne le transmettent pas, lien copié-collé dans un nouvel onglet, politique de referrer stricte. À l'inverse, ChatGPT ajoute souvent utm_source=chatgpt.com aux liens qu'il cite, ce qui sauve une partie des visites.
Quand la provenance est transmise, chatgpt.com atterrissait longtemps dans « Referral », au milieu des annuaires. Depuis le 13 mai 2026, GA4 dispose d'un canal par défaut « AI Assistant », avec trois limites : il n'est pas rétroactif, il ne reconnaissait pas Perplexity lors de notre veille d'août 2026, et certaines sources arrivent sans support — sur notre site, des visites de copilot.com remontaient en « (not set) », hors du canal natif.
Enfin, les volumes sont faibles. Selon SE Ranking (21 juin 2026, 101 574 sites français équipés de GA4), le trafic venant des IA pèse 0,26 % du trafic des sites français, dont 77,2 % pour ChatGPT. Pour une PME, quelques dizaines de sessions par mois : chaque visite mal classée pèse lourd.
Additionner tout sous l'étiquette « crawlers IA » est l'erreur de départ :
| Famille | User-agents principaux | Ce qu'ils font | Ce que leur passage t'apprend |
|---|---|---|---|
| Entraînement | GPTBot, ClaudeBot, CCBot, Bytespider, meta-externalagent | Collectent des pages pour entraîner les modèles | Ton contenu entre dans un corpus — ni visite, ni citation |
| Recherche | OAI-SearchBot, Claude-SearchBot, PerplexityBot | Alimentent l'index où l'assistant choisit ses sources | Ta page est candidate à la citation |
| Agents à la demande | ChatGPT-User, Claude-User, Perplexity-User, MistralAI-User | Lisent une page parce qu'un utilisateur vient de poser une question | Le signal le plus proche d'une demande réelle |
Deux précisions évitent des contresens. Google-Extended n'est pas un robot : c'est un jeton robots.txt qui règle l'usage de ton contenu pour Gemini, Google explorant avec ses user-agents habituels — une requête signée « Google-Extended » est donc suspecte par construction. Et les AI Overviews comme Copilot s'appuient sur les index de Googlebot et de Bingbot, indiscernables de l'exploration classique.
Le phénomène pèse lourd : selon le rapport Cloudflare du 1er juillet 2026, 52 % des requêtes de crawl relevaient de l'entraînement IA en juin 2026, contre 22 % au printemps 2025. Faut-il bloquer ou autoriser ces robots pour être cité ? C'est une question d'optimisation, traitée dans notre guide GEO pour ChatGPT et Perplexity.
Aucune source ne voit tout : GA4 mesure les visites humaines consenties, les logs serveur ce qui atteint ton origine, Cloudflare tout ce qui touche le réseau — il faut les croiser en connaissant l'angle mort de chacune.
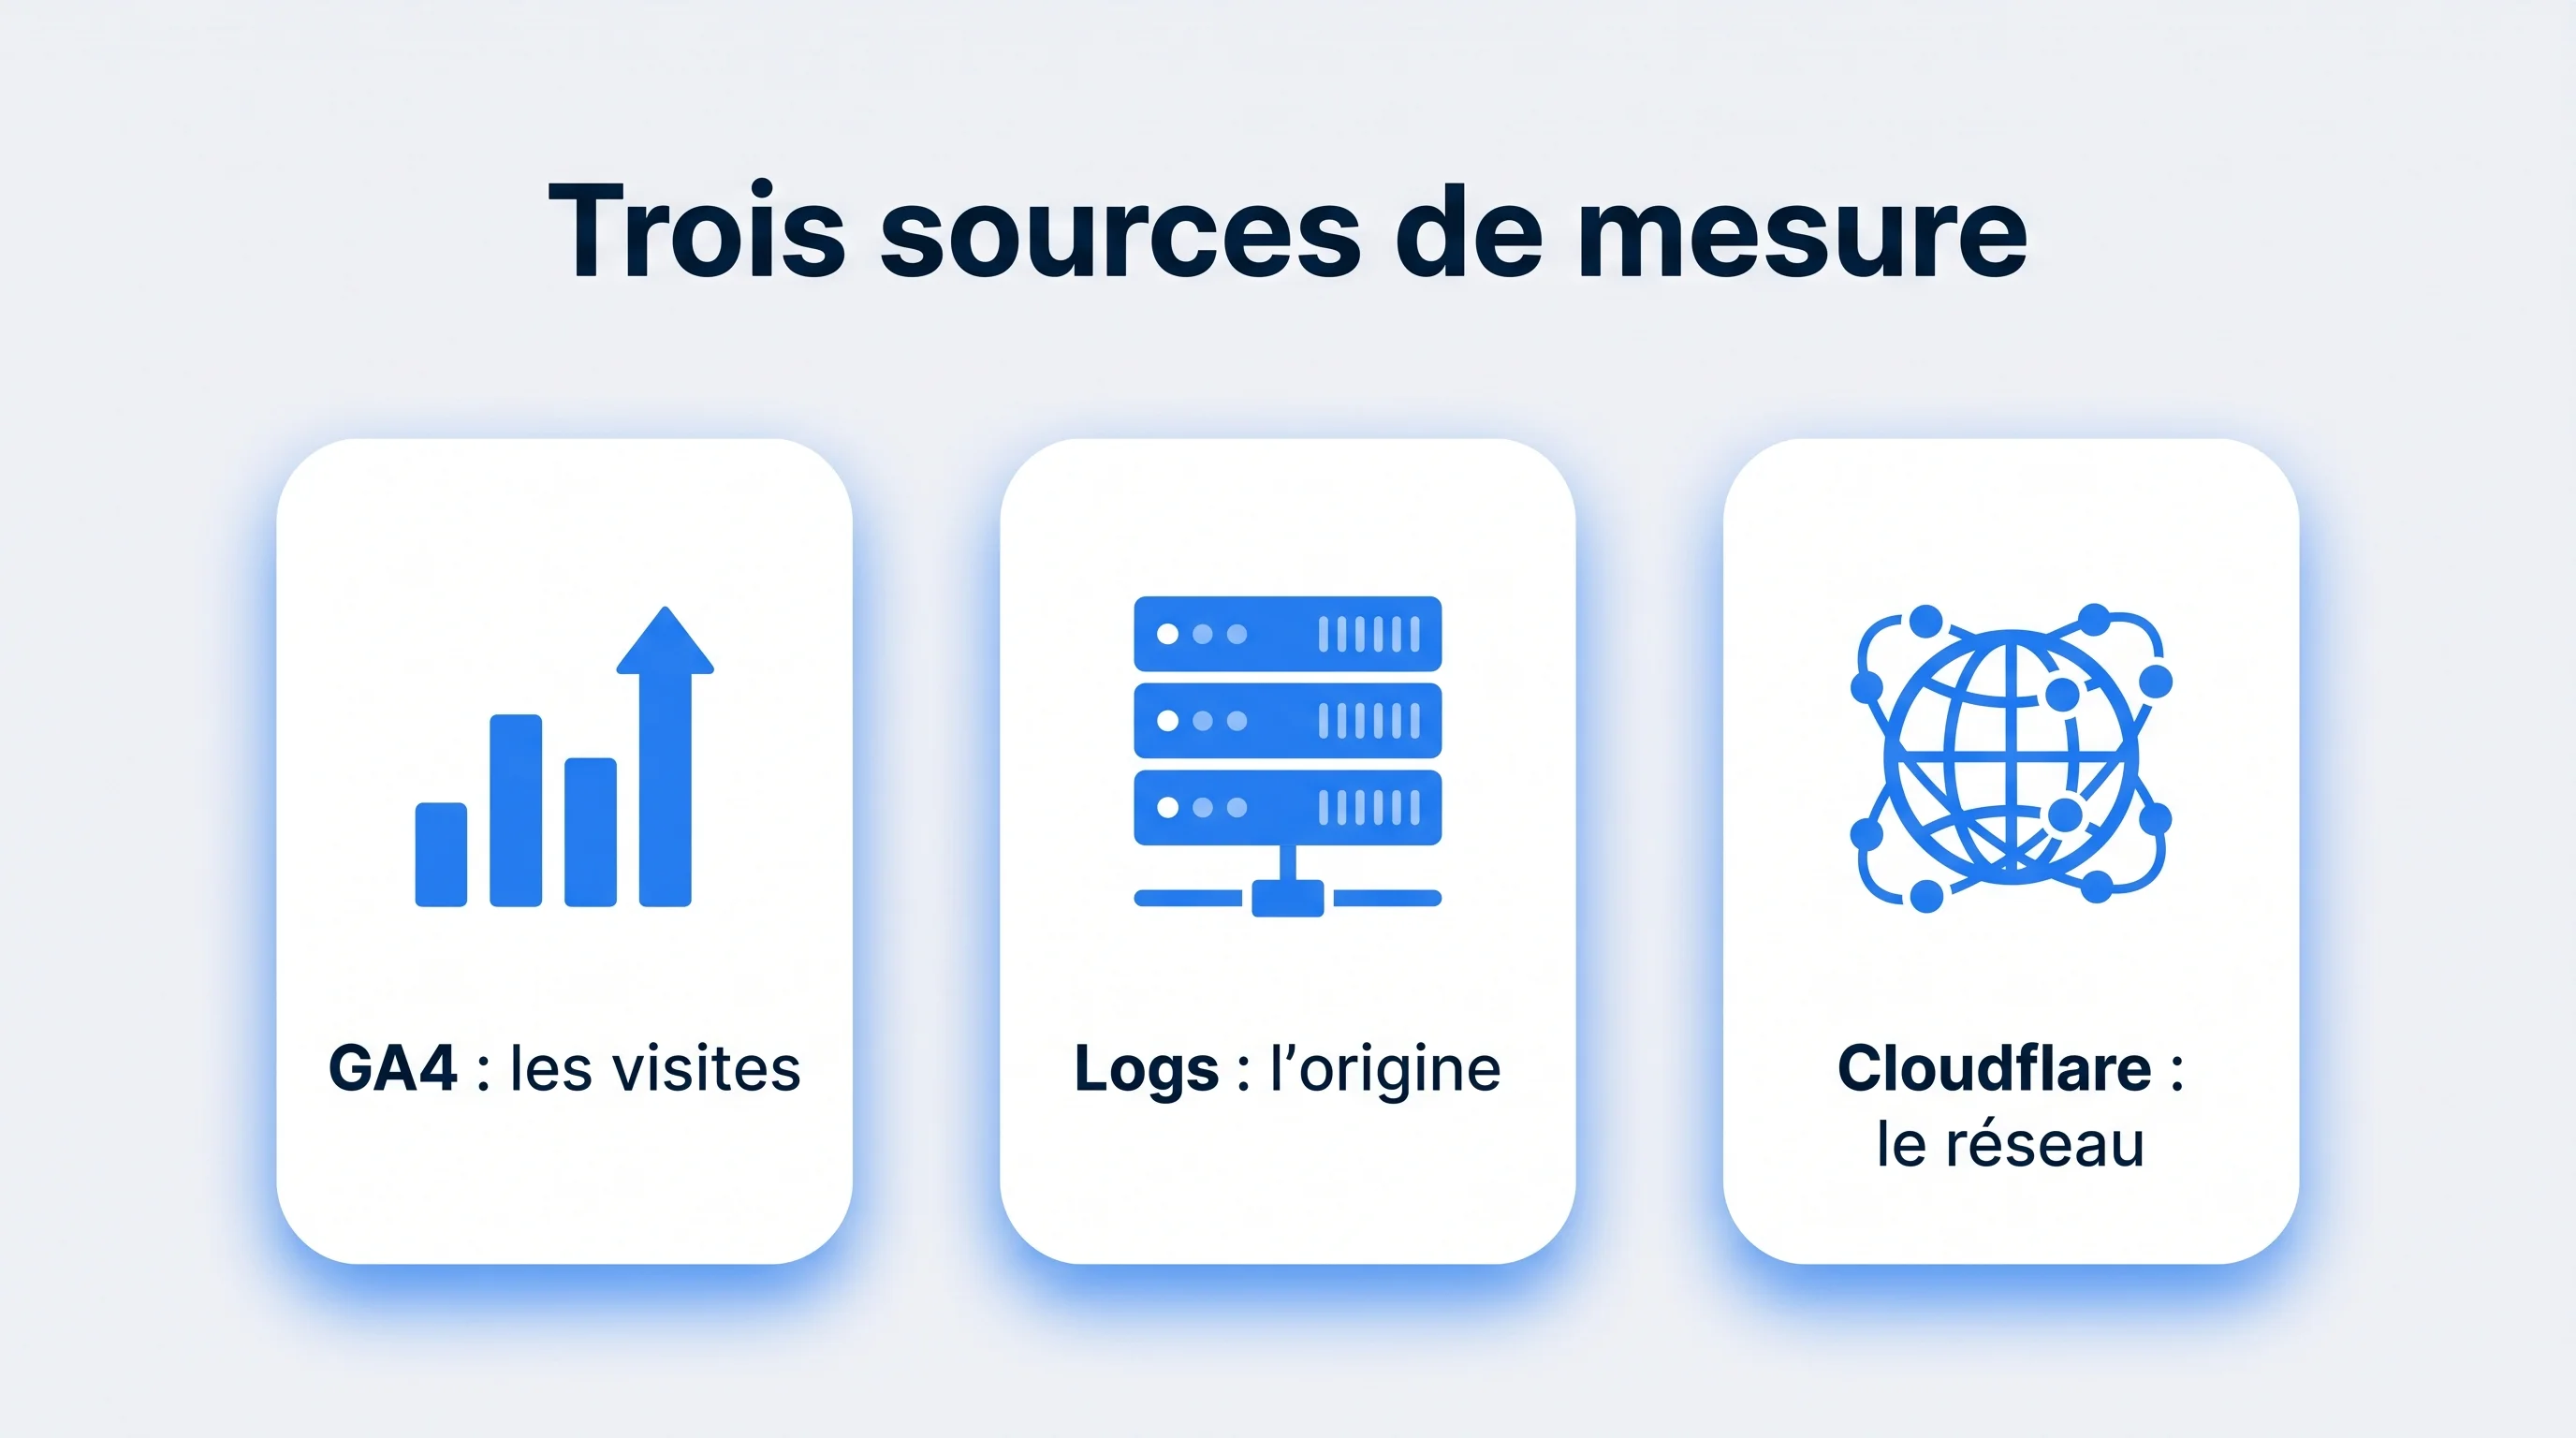
| Source | Ce qu'elle voit | Angle mort |
|---|---|---|
| GA4 | Les visites humaines qui exécutent le tag et acceptent la mesure | Les robots, les visites sans referrer, les refus de consentement |
| Logs serveur | Les requêtes qui atteignent ton serveur, robots compris | Ce que le CDN sert depuis son cache |
| Cloudflare | Toutes les requêtes, avant le cache | L'identité réelle du robot, faute de vérification |
Retiens surtout que GA4 ne voit pas les crawlers, qui n'exécutent pas le tag. Et logs comme Cloudflare comptent des requêtes, pas des sessions : les chiffres se croisent, ils ne s'additionnent pas.
Les journaux d'accès (nginx, Apache) enregistrent chaque requête avec son user-agent, son URL, son code de réponse et son referrer — à condition qu'ils existent. Sur notre serveur, l'access_log avait été désactivé « pour améliorer les performances » : impossible de savoir si GPTBot avait seulement lu le site. Bufferisé, un journal ne coûte presque rien :
access_log /var/log/nginx/monsite.access.log combined buffer=32k flush=1m;
Pour compter les passages par robot, filtre uniquement le champ user-agent, pas la ligne entière — sinon une URL contenant « gptbot » fausse le compte. Nous avons corrigé exactement ce bug dans notre propre script :
# Format combined : le user-agent est le 6e champ en découpant sur les guillemets
awk -F'"' '{ print $6 }' /var/log/nginx/monsite.access.log \
  | grep -oE 'GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|PerplexityBot|Perplexity-User|Bytespider' \
  | sort | uniq -c | sort -rn
La limite apparaît derrière un CDN. Nos requêtes de contrôle sur /llms.txt n'ont laissé aucune trace dans le journal : l'en-tête cf-cache-status: HIT montrait que Cloudflare servait la page depuis son cache. Si ton CDN met le HTML en cache, tes logs donnent un plancher, pas un total.
Ne désactive pas le cache pour « mieux compter » les robots : tu paierais en performance une mesure disponible ailleurs. Prends le chiffre là où il est complet — au bord du réseau — et garde les logs pour les codes de réponse réellement servis par ton origine. Et ne pilote jamais sur une seule source.
Si ton site passe par Cloudflare, la mesure complète existe déjà. AI Crawl Control, disponible sur tous les plans, liste les crawlers IA par éditeur et les pages qu'ils consultent. Pour croiser robots, pages et codes de réponse, l'API GraphQL expose le dataset httpRequestsAdaptiveGroups avec les dimensions userAgent, clientRequestPath, edgeResponseStatus et clientRefererHost (réservée aux plans payants), via un jeton Zone → Analytics → Read :
{
  viewer {
    zones(filter: { zoneTag: "TON_ZONE_ID" }) {
      httpRequestsAdaptiveGroups(
        limit: 5000
        orderBy: [count_DESC]
        filter: {
          datetime_geq: "2026-09-01T00:00:00Z"
          datetime_leq: "2026-09-30T23:59:59Z"
          requestSource: "eyeball"
          OR: [{ userAgent_like: "%GPTBot%" }, { userAgent_like: "%ChatGPT-User%" }]
        }
      ) {
        count
        dimensions { userAgent clientRequestPath edgeResponseStatus }
      }
    }
  }
}
En filtrant sur clientRefererHost_like (%chatgpt.com%…), tu obtiens les visites humaines venues des assistants vues au bord du réseau, indépendamment du consentement : le contrôle de cohérence idéal pour GA4. Un écart est normal ; un écart qui se creuse signale un tag cassé ou un problème de consentement. Cette requête a sa place dans un rapport automatisé, sur le modèle de notre audit SEO technique automatisé.
Dans GA4, quatre gestes suffisent : un groupe de canaux « Assistants IA » défini par regex, placé avant « Referral », une exploration dédiée et des dimensions personnalisées pour l'attribution.
Dans Administration → Paramètres des données → Groupes de canaux, copie le groupe par défaut pour conserver les canaux standards. Ajoute un canal Assistants IA avec la condition Source correspond à l'expression régulière :
^(.*\.)?(chatgpt\.com|chat\.openai\.com|perplexity\.ai|copilot\.microsoft\.com|copilot\.com|gemini\.google\.com|claude\.ai|mistral\.ai|you\.com|grok\.com)$
Le préfixe (.*\.)? couvre les sous-domaines (www.perplexity.ai, chat.mistral.ai). Les ancres ^ et $ évitent les faux positifs : gemini.google.com est capturé, pas google.com. Et la source reprend la valeur de utm_source : les visites marquées utm_source=chatgpt.com sont couvertes même sans referrer. Relis la liste chaque trimestre.
GA4 évalue les canaux de haut en bas et s'arrête à la première règle qui correspond. Si « Referral » est au-dessus, une visite de chatgpt.com avec le support referral y tombe avant d'atteindre ta règle. Avantage décisif sur le canal natif : un groupe de canaux personnalisé s'applique aussi aux données historiques.
Crée une exploration libre : en lignes, ton groupe de canaux puis la page de destination ; en valeurs, sessions, sessions avec engagement et événements clés. Prudence en comparant l'engagement avec l'organique : selon Slobodan Manic (Search Engine Journal, 5 août 2026), les visites IA atterrissent surtout sur l'accueil et les pages produit, quand l'organique est dominé par le blog.
Un paramètre envoyé sans dimension déclarée n'apparaît dans aucun rapport. Déclare dans Définitions personnalisées trois dimensions de portée événement : first_touch_channel, first_touch_source et first_touch_landing — non rétroactives, donc à poser tôt. Marque ta conversion (generate_lead) comme événement clé. Sur un site Nuxt, Next ou toute application web monopage, vérifie aussi que les changements de page sont mesurés : un tag installé « à l'ancienne » ne voit souvent que la première page.
Pour juger les assistants IA, le canal qui compte est celui de la première visite : le prospect découvre ton entreprise dans une réponse de ChatGPT, revient quelques jours plus tard en tapant ton adresse — et GA4 attribue son lead à Direct.
GA4 propose bien une dimension « premier canal de l'utilisateur », mais elle dépend du cookie — si le visiteur a refusé la mesure lors de sa première visite, elle est faussée — et ne remonte pas dans ton CRM. D'où une attribution first-touch maîtrisée, en quatre principes :
utm_source d'abord, referrer ensuite, « direct » sinon.gtag('set', …), pour qu'elle soit portée par tous les événements, dont generate_lead.const IA = /(^|\.)(chatgpt\.com|perplexity\.ai|claude\.ai|gemini\.google\.com|copilot\.microsoft\.com|mistral\.ai)$/
const DUREE = 90 * 24 * 60 * 60 * 1000 // 90 jours
function sourceActuelle() {
const utm = new URLSearchParams(location.search).get('utm_source')
if (utm) return utm.toLowerCase()
if (!document.referrer) return '(direct)'
const hote = new URL(document.referrer).hostname
return hote === location.hostname ? '(direct)' : hote
}
let first = null
try { first = JSON.parse(localStorage.getItem('first_touch')) } catch (e) { first = null }
if (!first || Date.now() - first.ts > DUREE) {
const source = sourceActuelle()
const channel = source === '(direct)' ? 'direct' : IA.test(source) ? 'assistant_ia' : 'autre'
first = { source, channel, landing: location.pathname, ts: Date.now() }
localStorage.setItem('first_touch', JSON.stringify(first))
}
// Paramètres globaux : portés par TOUS les événements envoyés ensuite
gtag('set', {
first_touch_channel: first.channel,
first_touch_source: first.source,
first_touch_landing: first.landing
})
Le stockage ne contient aucune donnée personnelle, mais valide-le avec ta politique de consentement. Sur Nuxt avec nuxt-gtag, passe par useGtag() : window.gtag n'existe pas toujours, et l'appel échoue en silence.
Ajouter l'attribution dans une fonction de suivi « maison » et croire qu'elle couvre tout le site. Chez nous, de nombreux composants (en-têtes des pages métier, blocs d'appel à l'action) appelaient gtag('event', …) directement : les formulaires portaient leur canal d'origine, les clics sur les boutons arrivaient sans. Poser l'attribution globalement avec gtag('set', …) a tout réglé d'un coup, y compris pour les événements collectés automatiquement.
Contactez-nous si tu veux qu'on vérifie ce que ton GA4 attribue vraiment — on te dit honnêtement si ta mesure tient la route.
Un user-agent n'est qu'une déclaration : une part importante des requêtes qui se présentent comme des crawlers IA viennent de scanners de failles qui empruntent leur nom pour passer les filtres anti-robots.
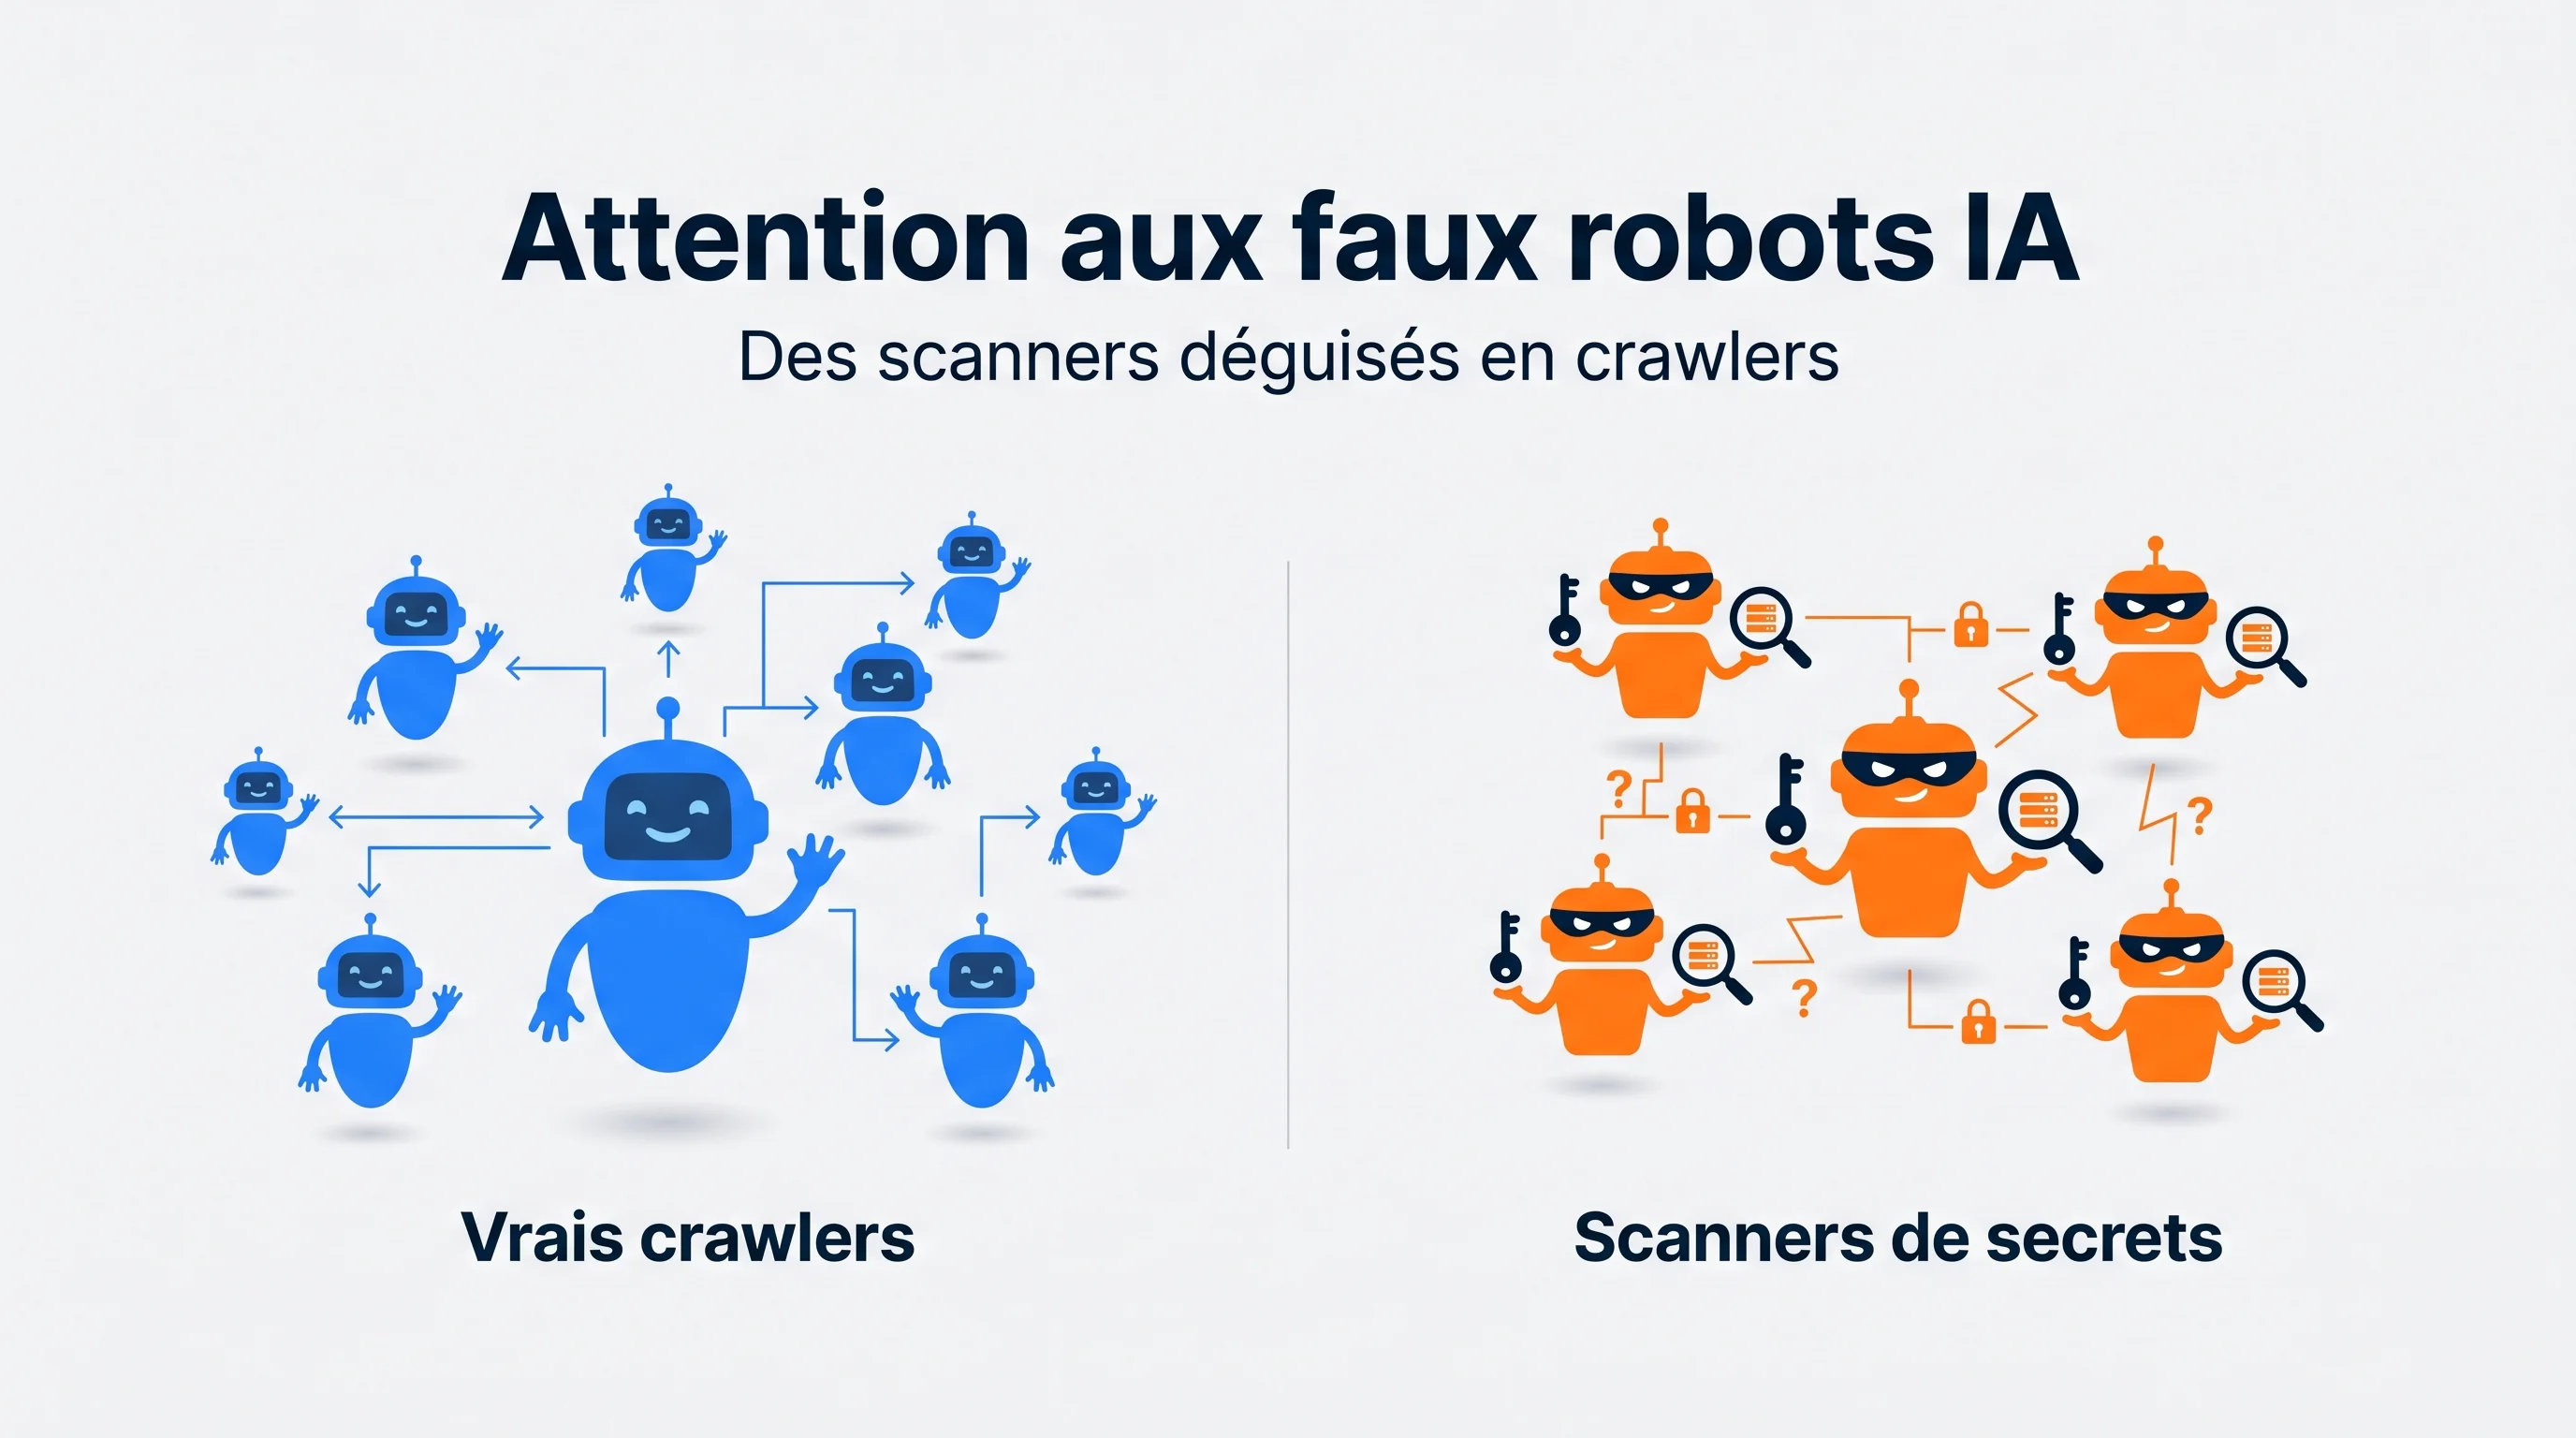
Sur notre site, les URL les plus demandées par les « crawlers IA » étaient /.env, /.env.local, /@fs/.env, /terraform.tfstate, /id_rsa, /config.js… Aucun crawler IA légitime ne demande ces fichiers : ce sont des scanners de secrets qui cherchent des mots de passe ou des clés oubliés, déguisés en GPTBot ou ClaudeBot parce que beaucoup de sites laissent passer les robots d'IA.
Le profil est instructif : plus un nom de robot est rare, plus il est usurpé. Sur Claude-SearchBot, Perplexity-User ou Google-Extended, les faux étaient même majoritaires ; les gros crawlers réellement actifs (Bytespider, meta-externalagent) étaient presque tous légitimes — la signature d'un scanner qui fait tourner une liste de user-agents.
Niveau 1 — les chemins de scan. Isole les requêtes « crawler IA » qui visent des chemins que seul un scanner demande. Gratuit, faisable sur les logs comme sur Cloudflare :
awk -F'"' '$6 ~ /GPTBot|ChatGPT-User|ClaudeBot|Claude-SearchBot|PerplexityBot|Perplexity-User|Google-Extended/ { split($2, req, " "); print req[2] }' /var/log/nginx/monsite.access.log \
  | grep -cE '/\.env|/\.git|/@fs/|id_rsa|terraform\.tfstate|config\.js'
Cette méthode donne un minimum de faux : un scanner qui demande une page ordinaire passe entre les mailles.
Niveau 2 — l'adresse IP. C'est la seule preuve. OpenAI et Perplexity publient les plages IP de leurs robots ; pour Googlebot et Bingbot, on vérifie par DNS inverse. Une requête signée GPTBot hors des plages OpenAI est fausse.
Niveau 3 — l'identification Cloudflare. La détection vérifiée des robots (botDetectionIds dans l'API) exige Bot Management, réservé à l'offre Enterprise. Sur les autres plans, on identifie par user-agent : les chemins de scan sont alors le meilleur substitut.
Des milliers d'erreurs servies aux « crawlers IA » ne justifient pas un chantier d'urgence : les 404 sur /.env sont la bonne réponse, les 403 souvent ton pare-feu qui fait son travail. Notre propre script levait cette fausse alerte. La vraie alerte, c'est une erreur servie à un robot vérifié sur une page réelle.
Un vrai crawler IA lit des pages publiques. Toute requête « crawler IA » vers un fichier de configuration, de clé ou de dépôt (/.env, /id_rsa, /.git, /terraform.tfstate) vient d'un scanner : exclus-la de tes compteurs, et juge la santé de ton site sur les seules erreurs servies aux pages réelles.
Un relevé mensuel court suffit : visites venues des assistants, leads produits en first-touch, et passages des vrais robots sur tes pages importantes.
| Indicateur | Où le lire | Ce qu'il te dit | Piège à éviter |
|---|---|---|---|
| Sessions « Assistants IA » et pages d'atterrissage | GA4 | Les visites identifiables et les contenus recommandés | Sous-estimé : une partie arrive en Direct |
| Leads par canal de première visite | GA4, first_touch_channel | Ce qui se rapproche le plus d'un ROI | Trois leads ne font pas une tendance |
| Passages des agents à la demande | Cloudflare ou logs | Tes pages servent à répondre à de vraies questions | Filtre d'abord les chemins de scan |
| Passages des robots de recherche | Cloudflare ou logs | Ton contenu est indexable par les moteurs de réponse | Un passage n'est pas une citation |
| Erreurs sur des pages réelles | Cloudflare, code × page | Les pages que les IA ne peuvent pas lire | Les 404 sur /.env ne comptent pas |
| Écart Cloudflare / GA4 | clientRefererHost contre sessions | La santé du tag et du consentement | C'est la dérive de l'écart qui alerte |
Trafic IA ne veut pas dire rentabilité. L'ordre de grandeur honnête pour une petite structure est celui publié par l'agence DIGITALOPS le 27 juin 2026 : 27 sessions ChatGPT en 28 jours pour une seule demande qualifiée. Et la seule étude à comité de lecture disponible (Marketing Science, 973 sites e-commerce, août 2024 – juillet 2025) trouve que le referral ChatGPT convertit environ 13 % moins bien que l'organique Google — loin des multiplicateurs spectaculaires qui circulent. Tant que tes leads attribués se comptent sur les doigts d'une main, tu mesures une présence, pas une rentabilité.
Une citation n'est pas une visite. Minecraft.fr l'a documenté le 2 mai 2026 : environ 1 million de citations dans Copilot en trois mois pour environ 1 000 visites par mois, soit 0,3 % de ses sessions. Les citations se mesurent autrement, comme expliqué dans notre article sur le GEO et la visibilité dans ChatGPT et Perplexity ; les clics perdus dans Google, via Search Console, comme dans notre analyse de l'impact d'AI Overview sur le SEO.
Le clic sous-estime l'influence. Omniscient Digital rapportait en janvier 2026 environ 5 % de trafic attribuable aux LLM par le clic, mais 30 à 40 % de leads déclarant un LLM comme source de découverte — une anecdote sans méthodologie, qui justifie pourtant une question « Comment nous avez-vous connus ? » dans ton formulaire.
Sur notre propre site, croiser ces trois sources a corrigé quatre lectures fausses en quelques semaines — et confirmé que le canal des assistants IA existe, sans permettre encore d'en juger la rentabilité.
La situation. czmultimedia.com est un site Nuxt 3 servi derrière Cloudflare. Après des mois de travail sur la visibilité dans les assistants IA, nous voulions savoir s'il produisait des visites, puis des demandes de devis.
Ce qui s'est passé, en septembre 2026 :
Ce que nous faisons désormais. Un relevé mensuel qui croise les trois sources, avec une règle écrite : aucune conclusion sur la rentabilité tant que les leads attribués ne distinguent pas un signal du hasard.
Coût et résultat. Aucun outil payant supplémentaire : il manquait la configuration et la méthode de lecture. C'est ce même socle — tag propre, attribution globale, journaux exploitables — que nous posons sur chaque projet de développement d'application web.
Un groupe de canaux « Assistants IA » existe dans GA4, défini par regex sur la source et placé avant « Referral »
Les dimensions first_touch_channel, first_touch_source et first_touch_landing sont déclarées en portée événement
L'attribution first-touch est posée en paramètres globaux et recopiée dans les champs cachés du formulaire
Le journal d'accès est activé, bufferisé, et analysé sur le seul champ user-agent
Les crawlers IA sont comptés au bord du réseau si ton CDN met le HTML en cache
Les requêtes vers des chemins de scan sont exclues des compteurs de crawlers IA
Le formulaire de contact demande comment le prospect a connu l'entreprise
Crée un groupe de canaux personnalisé « Assistants IA » défini par une regex sur la source (chatgpt.com, perplexity.ai, gemini.google.com, claude.ai…), placé avant « Referral ». Contrairement au canal natif « AI Assistant » de mai 2026, il s'applique à l'historique.
GA4 n'identifie un assistant que si le navigateur transmet un referrer ou si l'URL porte un utm_source. Applications mobiles, navigateurs intégrés et liens copiés-collés arrivent souvent sans l'un ni l'autre.
GPTBot collecte des pages pour l'entraînement, OAI-SearchBot alimente l'index de ChatGPT search, ChatGPT-User lit une page à la demande d'un utilisateur. OpenAI précise que les règles robots.txt peuvent ne pas s'appliquer à ChatGPT-User, puisque la visite est déclenchée par une personne.
Pas si un CDN met ton HTML en cache : ces requêtes n'atteignent jamais le serveur. Chez Cloudflare, AI Crawl Control (tous les plans) et l'API GraphQL comptent toutes les requêtes au bord du réseau.
Isole d'abord les requêtes vers des chemins de scan (/.env, /id_rsa, /.git) : aucun crawler IA légitime ne les demande. La preuve passe par l'adresse IP (plages publiées par l'éditeur, DNS inverse) ou par Cloudflare Bot Management, réservé à l'offre Enterprise.
Les sessions ne permettent pas de le dire : le trafic IA pèse 0,26 % du trafic des sites français (SE Ranking, juin 2026). Seuls les leads attribués en first-touch, suivis sur plusieurs mois, permettent de juger.
Tout cela tient avec les outils que tu as déjà : il manque surtout une configuration propre et une lecture qui croise les sources.
Contactez-nous — réponse sous 24h, sans engagement, et on te dit honnêtement ce que ta mesure actuelle permet de conclure.
J’aide les PME à améliorer leur site web et leurs projets digitaux pour générer plus de demandes clients.
Je vous propose un audit gratuit, rapide et sans engagement.
Sans engagement • Recommandations concrètes • Réponse sous 24h
GEO : la nouvelle discipline qui optimise ton site pour être cité par ChatGPT, Perplexity, Gemini. 7...
Comparatif des agences IA à Lyon en 2026 : critères, fourchettes de prix, pièges. Comment choisir, e...
AI Overview en France : -34% de clics organiques sur certaines requêtes. 5 leviers pour rester visib...
Découvrez comment développer votre propre assistant intelligent, étape par étape, avec les outils d'...

Maîtrisez le prompt engineering en entreprise : 6 techniques concrètes, templates copiables, erreurs...
Méthode en 30 jours pour déployer ChatGPT en B2B : 7 cas d'usage ROI, garde-fous sécurité, templates...