Mistral, OpenAI ou Claude : quel LLM en entreprise ?
Comparatif mi-2026 Mistral, OpenAI, Claude pour entreprise française : prix API, RGPD, Cloud Act, co...

Un RAG est un excellent moyen de faire répondre une IA sur tes documents internes, mais pas un système fiable par défaut : sans jeu de questions de référence et sans mesure séparée de la recherche et de la génération, tu ne sais ni combien de réponses sont fausses, ni si ta dernière modification a amélioré les choses ou les a dégradées.
La scène est classique. L'assistant documentaire est en ligne depuis quelques semaines, l'équipe l'utilise, les retours sont plutôt bons. Puis un commercial transmet à un client une réponse sur des conditions de garantie qui n'existent dans aucun contrat. L'assistant l'a formulée avec la même assurance que d'habitude, en citant une source qui ne dit pas ça. Personne ne sait depuis quand ce genre d'erreur arrive, ni à quelle fréquence.
C'est la question qu'on nous pose de plus en plus souvent en cadrage de projets de RAG d'entreprise : « comment on sait que l'assistant dit vrai ? ». La réponse honnête : on ne le sait que si on le mesure, avec une méthode écrite avant la mise en production, et rejouée à chaque changement.
Évaluer un RAG, c'est mesurer séparément ses deux étages : la récupération (le système a-t-il trouvé les bons passages ?) et la génération (le modèle a-t-il répondu fidèlement à partir de ces passages ?). La méthode tient en quatre briques : un jeu de questions de référence tiré des vraies questions des utilisateurs, trois indicateurs (pertinence des documents récupérés, fidélité au contexte, exactitude de la réponse), un juge (humain, LLM-juge calibré, ou les deux) et une évaluation rejouée à chaque mise à jour. CZ Multimédia inclut cette évaluation qualité dans tout MVP RAG mis en production, facturé 4 000 à 8 000 € HT avec hébergement en Europe et authentification.
Pour un cadrage sur ton projet : Contactez-nous
Un RAG se trompe pour deux raisons très différentes : soit la recherche n'a pas ramené le bon passage, soit le modèle a mal utilisé ce qu'on lui a donné — et tant que tu ne sais pas laquelle, tu corriges au hasard.
Rappel en deux phrases : un RAG (Retrieval-Augmented Generation) cherche d'abord dans tes documents les passages les plus proches de la question, puis les transmet à un modèle de langage avec la consigne de répondre à partir d'eux. Si tu veux le détail de l'architecture (découpage, embeddings, base vectorielle, re-ranking), notre guide pratique du RAG pour PME le couvre. Ici, on s'intéresse à une seule question : comment savoir s'il répond juste.
La recherche est le premier étage, et c'est souvent là que tout se joue. Si le bon passage n'est pas dans le contexte transmis au modèle, la meilleure consigne du monde ne le fera pas apparaître. Les causes qu'on rencontre le plus en audit :
Même avec les bons passages dans le contexte, le modèle peut se tromper. Ce sont les hallucinations au sens strict :
Changer de modèle de langage dès que l'assistant se trompe. Dans les projets qu'on reprend, une bonne partie des mauvaises réponses vient de la recherche : le modèle n'a jamais vu le bon passage. Un modèle plus puissant ne corrige pas un document mal découpé ; il rend juste l'erreur plus convaincante.
La réponse finale seule te dit qu'il y a une erreur, pas où corriger. En mesurant ce que la recherche a ramené, puis ce que le modèle en a fait, chaque erreur se range dans une case : défaut d'index ou de découpage (on retravaille l'ingestion), défaut de classement (on ajuste la recherche ou le re-ranking), défaut de génération (on travaille la consigne, le format de contexte ou le modèle). C'est cette séparation qui transforme « l'assistant raconte parfois n'importe quoi » en liste de corrections priorisées.
Le jeu de questions de référence est la pièce maîtresse de l'évaluation : sans lui, chaque test est une impression ; avec lui, chaque modification se compare à la précédente sur les mêmes questions.
On l'appelle aussi golden set ou jeu de test. C'est une liste de questions, chacune accompagnée de la réponse attendue et des documents qui la justifient. On le rejoue à l'identique à chaque évolution, comme des tests de non-régression dans un logiciel.
La règle : des questions réelles, pas des questions inventées par l'équipe projet. Les questions qu'un développeur imagine sont trop propres, trop proches du vocabulaire des documents, et passent presque toujours. Les bonnes sources :
Un jeu utile ne contient pas que des questions faciles. On veille à couvrir plusieurs familles :
| Famille | Exemple de type de question | Ce qu'elle teste |
|---|---|---|
| Factuelle simple | « Quel est le délai de livraison standard ? » | La recherche trouve un passage unique |
| Multi-documents | « Quelles différences entre l'offre A et l'offre B ? » | Le système rassemble plusieurs sources |
| Conditionnelle | « Le client X a-t-il droit à la garantie dans tel cas ? » | Le modèle respecte les exceptions |
| Sans réponse dans le corpus | Une question plausible que tes documents ne traitent pas | Le système sait s'abstenir |
| Obsolescence | Une question dont la réponse a changé récemment | La version en vigueur passe devant l'ancienne |
| Vocabulaire métier | Sigles internes, références produits, synonymes | La recherche gère ton jargon |
La famille « sans réponse » est la plus négligée et la plus révélatrice : elle mesure la propension du système à inventer. Un assistant qui sait dire « je ne trouve pas » vaut plus qu'un assistant qui répond à tout.
Pour chaque question, on note au minimum :
Le champ « documents sources » est celui qui permet de mesurer la récupération indépendamment de la génération. Sans lui, tu ne sais pas si le bon passage est remonté.
Des outils open source génèrent des questions à partir de tes documents avec un modèle de langage : pratique pour élargir la couverture d'un gros corpus. Mais ces questions reprennent le vocabulaire exact du document source, donc la recherche les trouve facilement. On les utilise en complément des questions réelles, et chacune est relue avant d'entrer dans le jeu.
Commence petit mais représentatif : quelques dizaines de vraies questions, réparties sur toutes les familles, avec une réponse validée par quelqu'un qui connaît le métier. Tu l'enrichiras ensuite avec chaque erreur repérée en production. Un jeu qui grandit avec les incidents vaut mieux qu'un gros jeu figé.
Trois indicateurs suffisent à piloter la qualité d'un RAG : la pertinence des documents récupérés (la recherche), la fidélité de la réponse au contexte (la génération) et l'exactitude de la réponse finale (le résultat pour l'utilisateur).
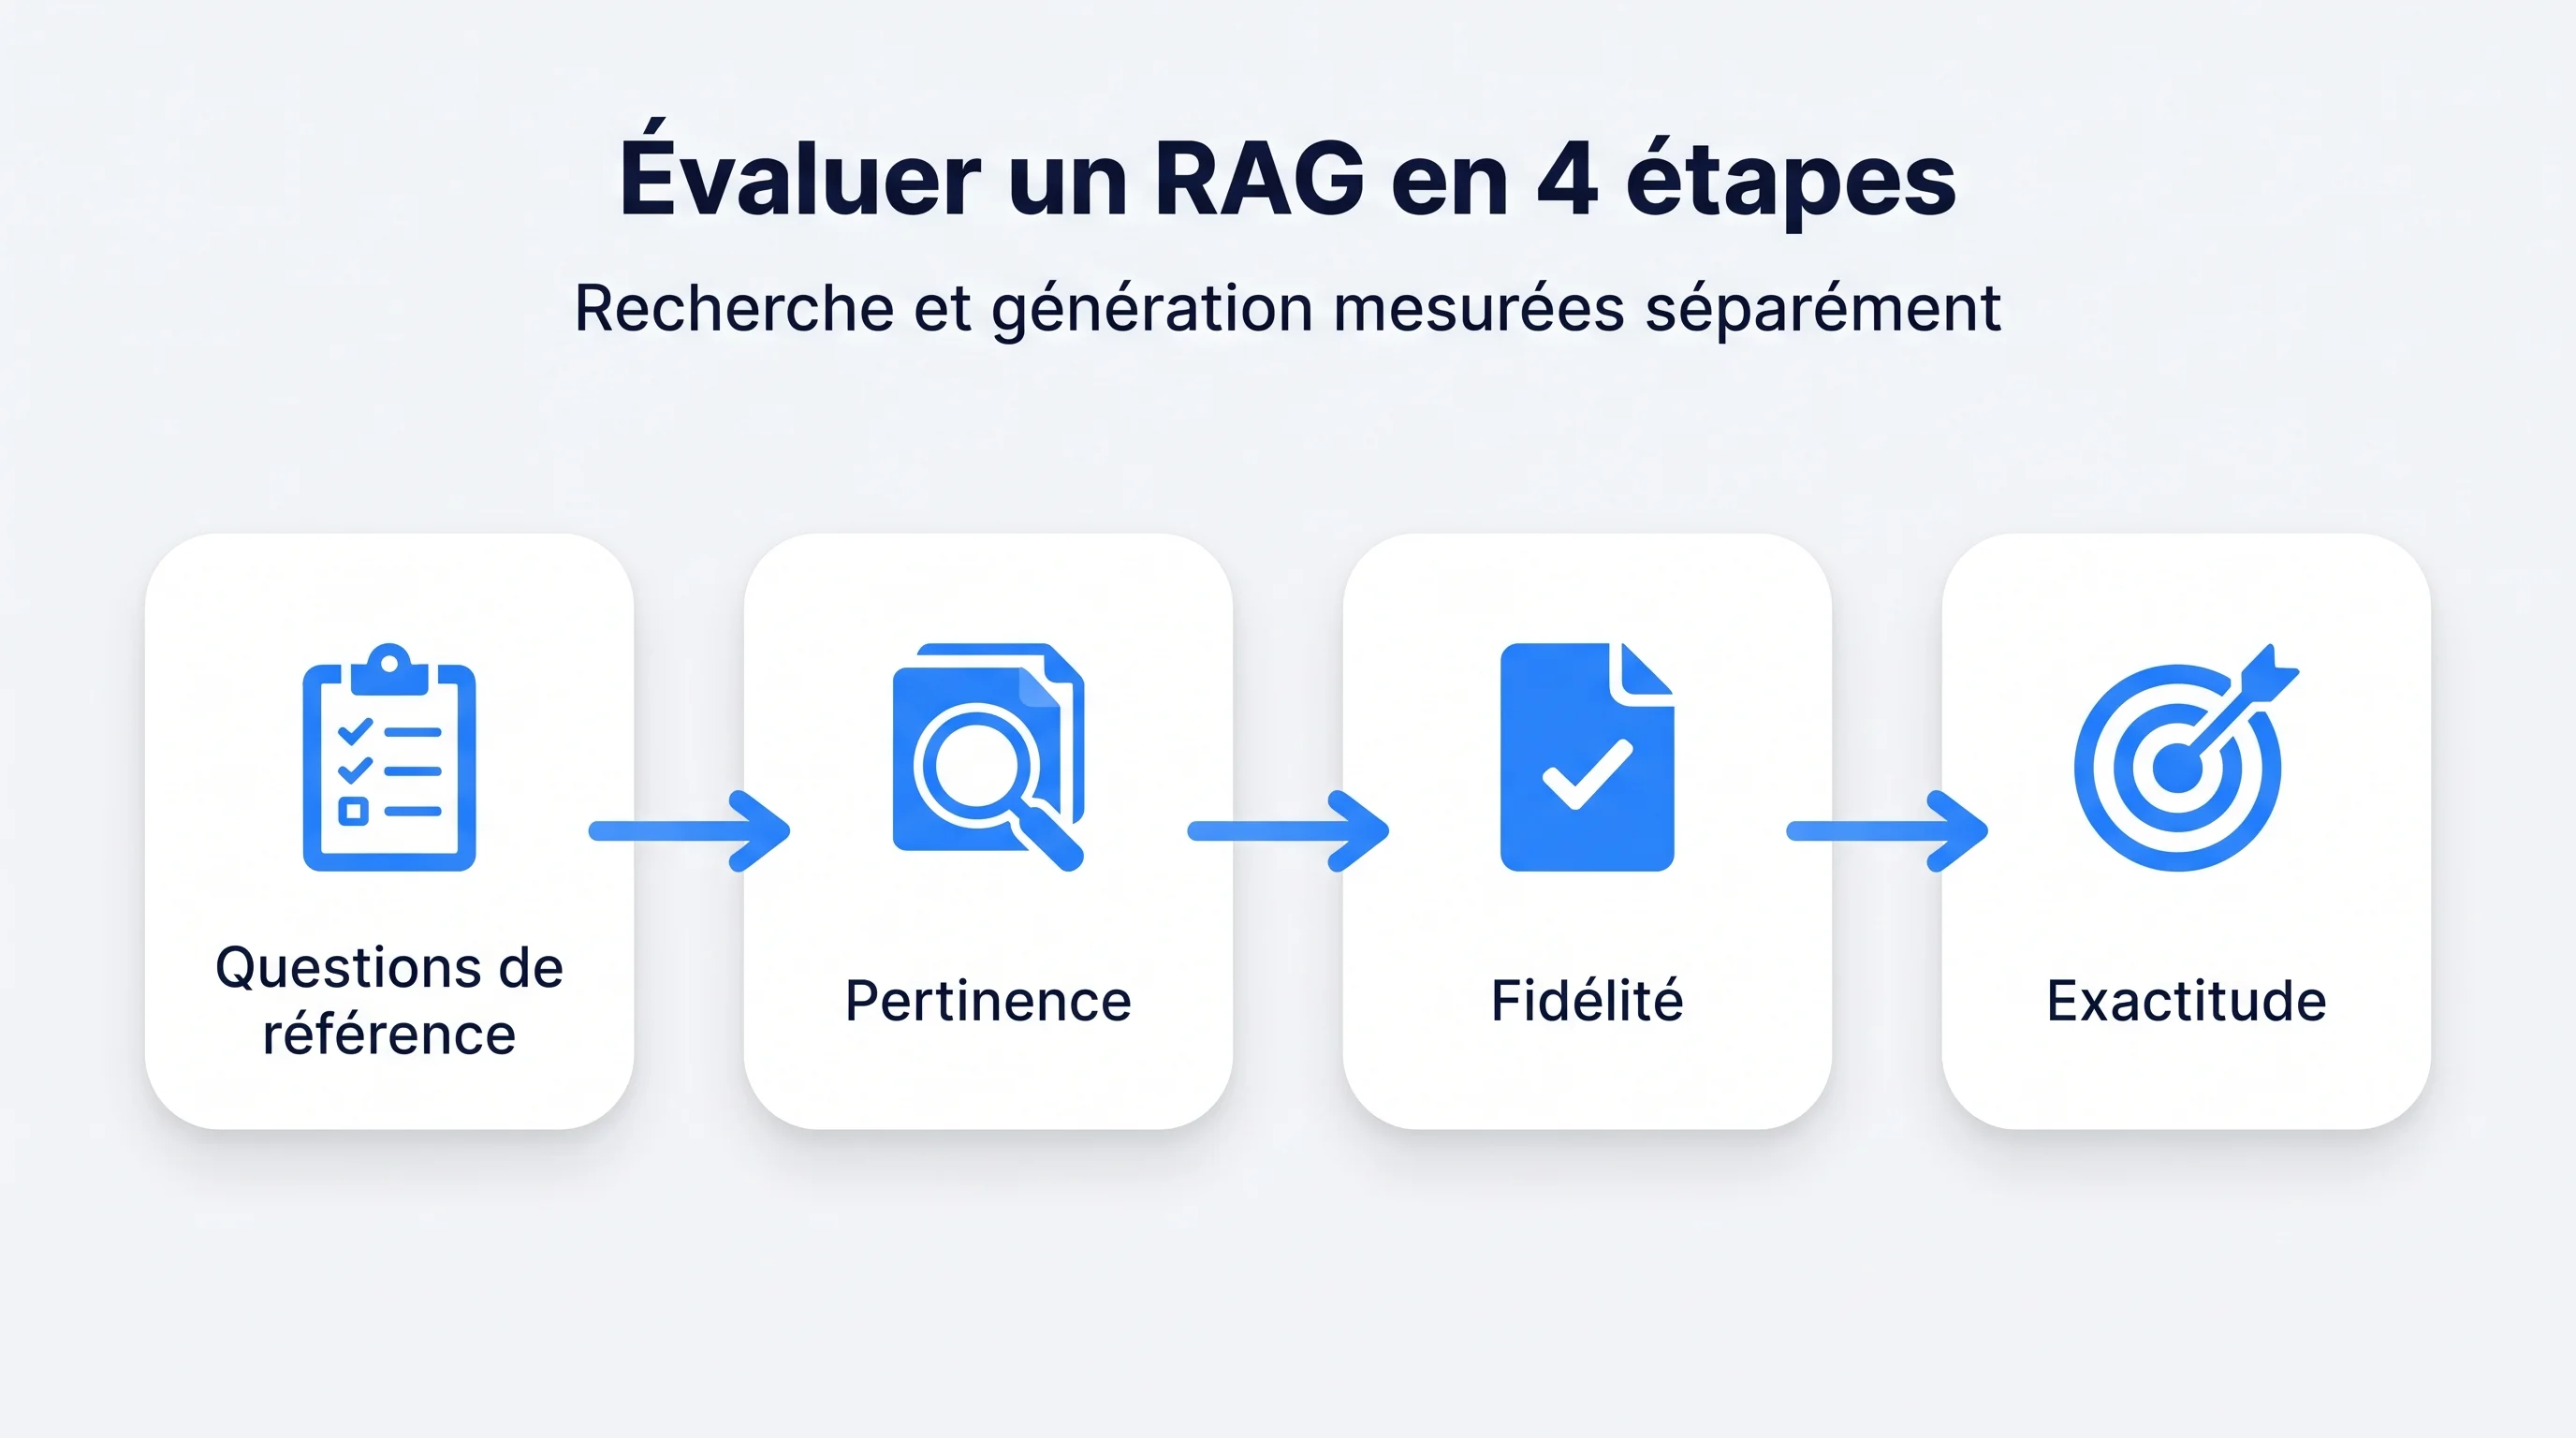
Il existe des dizaines de métriques ; ces trois-là suffisent pour commencer, car chacune pointe vers une correction différente.
Question posée : la recherche a-t-elle ramené les passages qui contiennent la réponse ?
On compare les passages transmis au modèle aux documents sources notés dans le jeu de référence. Deux angles :
Cet indicateur se calcule sans juger la réponse du modèle, ce qui permet de tester un changement de découpage ou d'embeddings rapidement, sans même lancer la génération.
Question posée : chaque affirmation de la réponse est-elle soutenue par les passages fournis ?
C'est l'indicateur anti-hallucination par excellence. On découpe la réponse en affirmations élémentaires, puis on vérifie, pour chacune, si elle se retrouve dans le contexte transmis. Une réponse est fidèle quand rien de ce qu'elle affirme ne vient d'ailleurs.
Point important : fidèle ne veut pas dire vrai. Si la recherche a ramené l'ancienne grille tarifaire, une réponse parfaitement fidèle reprendra des prix périmés. Inversement, une réponse peut être vraie mais infidèle, si le modèle l'a tirée de sa mémoire générale. Pour un assistant métier, c'est un défaut même quand la réponse est juste : le jour où ta pratique diffère de la pratique générale du secteur, il se trompera sans prévenir.
On mesure aussi dans cette catégorie le respect de l'abstention : sur les questions sans réponse dans le corpus, le système a-t-il dit qu'il ne savait pas ?
Question posée : la réponse finale est-elle correcte et complète par rapport à la réponse attendue ?
C'est l'indicateur que regarde l'utilisateur. On compare la réponse produite à la réponse validée par l'expert : les éléments essentiels sont-ils présents ? Y a-t-il une erreur, même mineure ? Il est utile de distinguer trois verdicts plutôt qu'un simple juste/faux : correcte, incomplète (rien de faux, mais il manque un élément important), incorrecte (au moins une affirmation fausse). Pondérée par la gravité notée dans le jeu, cette mesure dit si l'assistant est utilisable en l'état.
C'est la combinaison qui fait le diagnostic :
| Pertinence récupération | Fidélité | Exactitude | Diagnostic probable |
|---|---|---|---|
| Faible | Bonne | Faible | La recherche ne trouve pas : travailler l'ingestion, le découpage, la recherche |
| Bonne | Faible | Faible | Le modèle invente ou mélange : travailler la consigne, le format du contexte, le modèle |
| Bonne | Bonne | Faible | Le corpus lui-même est faux ou obsolète : nettoyer les documents |
| Faible | Faible | Bonne | Le modèle répond de mémoire : réponse juste aujourd'hui, risquée demain |
| Bonne | Bonne | Bonne | Le système fonctionne sur ce type de question |
La troisième ligne surprend souvent : un RAG fidèle à des documents faux donne des réponses fausses. L'évaluation sert alors aussi à repérer les documents à mettre à jour ou à retirer de l'index.
Plusieurs bibliothèques open source automatisent ces mesures. Ragas est l'une des plus citées : elle propose notamment des métriques de fidélité (faithfulness), de pertinence de la réponse et de précision et rappel du contexte, en s'appuyant sur un modèle de langage pour juger. D'autres outils existent dans le même registre (DeepEval, promptfoo, ou des plateformes d'observabilité comme Langfuse qui gèrent jeux de données et expériences). Les noms de métriques, leurs définitions exactes et leurs API évoluent d'une version à l'autre : avant de comparer deux scores, vérifie qu'ils ont été produits par la même version, avec le même modèle juge. Et garde en tête qu'un score automatique n'a de valeur que si tu as vérifié, sur un échantillon, qu'il est d'accord avec un humain.
Le juge humain est la référence, le LLM-juge est l'outil qui permet de passer à l'échelle : la bonne pratique consiste à calibrer le second sur le premier, pas à choisir l'un contre l'autre.
La pertinence de la récupération se calcule presque mécaniquement à partir du jeu de référence. La fidélité et l'exactitude, elles, demandent de lire et de comprendre une réponse. Quelqu'un, ou quelque chose, doit trancher.
Un expert métier qui relit une réponse sait si elle est juste, si elle oublie une condition importante, si elle serait dangereuse transmise à un client. C'est irremplaçable pour :
Sa limite : le temps. Relire tout le jeu à chaque modification du prompt devient vite intenable. Pour une notation exploitable, il faut une grille écrite (correcte / incomplète / incorrecte, avec exemples) et, si possible, deux relecteurs sur un échantillon pour vérifier qu'ils notent pareil.
Un LLM-juge est un modèle de langage à qui l'on donne la question, le contexte récupéré, la réponse produite et la réponse attendue, avec une consigne de notation précise. Il note en quelques minutes ce qu'un humain mettrait des heures à relire, ce qui rend possible une évaluation complète à chaque changement.
Ses biais sont documentés dans la littérature, notamment dans l'étude de Zheng et al. (2023) qui a popularisé l'approche LLM-as-a-judge : biais de position (préférence pour la première réponse présentée quand on en compare deux), biais de verbosité (préférence pour les réponses longues) et biais d'auto-complaisance (tendance à favoriser les réponses produites par un modèle de la même famille). S'y ajoutent des limites pratiques : un juge peut manquer une erreur subtile dans un domaine technique, ou être trop sévère sur une formulation différente mais correcte.
On ne fait confiance à un LLM-juge qu'après l'avoir confronté à des notes humaines :
Quelques règles pratiques réduisent les biais : utiliser comme juge un modèle différent de celui qui génère les réponses, éviter les comparaisons deux à deux quand une notation absolue suffit, demander une décision par affirmation (soutenue ou non par le contexte) plutôt qu'une note globale, et figer la version du modèle juge pour que les scores restent comparables dans le temps.
On ne livre pas un RAG dont la qualité n'est jugée que par un LLM. Le LLM-juge sert à rejouer le jeu de référence à chaque modification ; l'humain valide les réponses attendues, calibre le juge et relit un échantillon en production. Un score automatique jamais confronté à un expert métier est un chiffre rassurant, pas une mesure.
Reste le bouton « réponse utile / pas utile » : un signal précieux car il vient de vraies questions, mais les utilisateurs notent peu et ne repèrent pas une réponse fausse qui semble plausible. On s'en sert comme alerte et comme source de nouvelles questions, pas comme juge.
Contactez-nous si tu as un assistant RAG en production sans jeu de référence ni mesure de fidélité : on te dit honnêtement par quoi commencer pour savoir ce qu'il vaut vraiment.
Un RAG évalué une seule fois, au lancement, n'est pas évalué : sa qualité dérive avec chaque document ajouté, chaque changement de modèle et chaque ajustement de prompt, et seule une évaluation rejouée systématiquement permet de le voir.
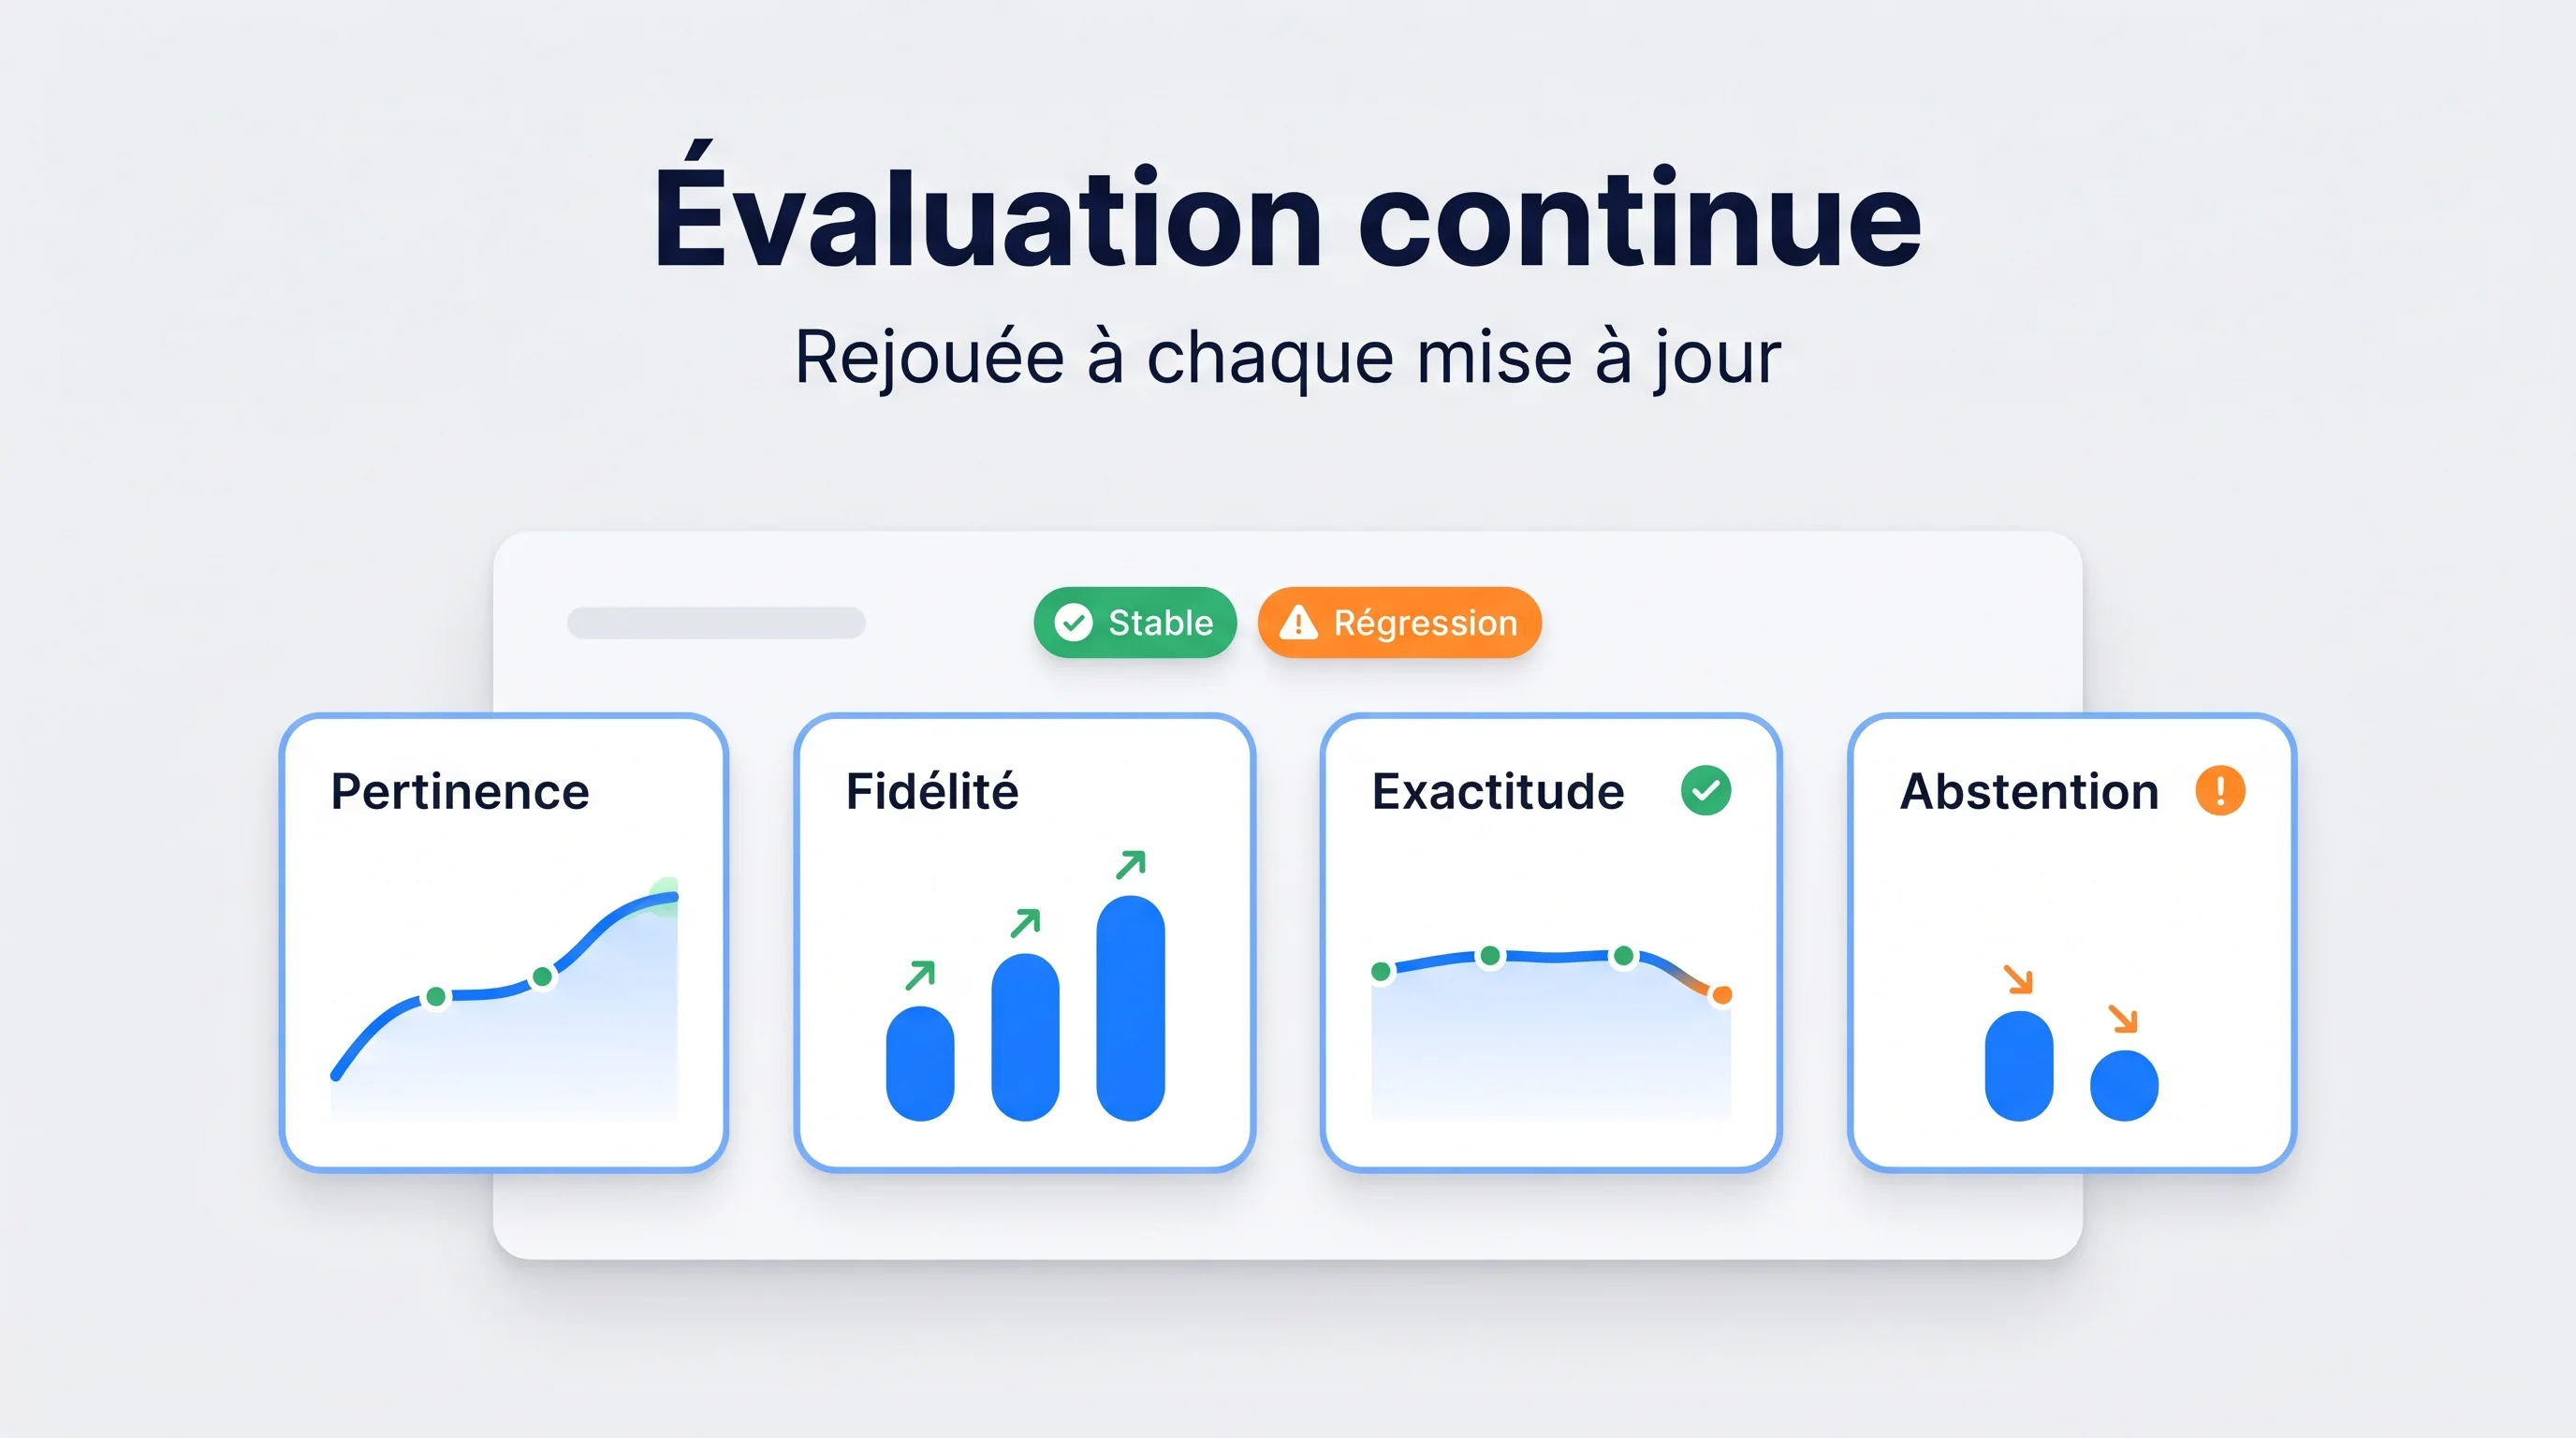
Les réponses d'un RAG dépendent de quatre éléments qui bougent : corpus, chaîne de recherche, consigne et modèle. C'est pourquoi notre article sur le RAG souverain hébergé en France fait de l'évaluation et du monitoring une étape à part entière de l'architecture de référence.
On rejoue le jeu de référence complet à chaque fois que l'un de ces éléments change :
La règle est simple : aucune modification ne part en production sans comparaison avec le score précédent. Si un indicateur baisse sur une famille de questions, on regarde les cas concernés avant de décider.
Des seuils écrits évitent les débats au cas par cas, par exemple : aucune nouvelle erreur sur les questions graves, pas de recul de l'abstention ni de la fidélité. Leur niveau dépend de l'usage : un assistant interne tolère plus d'incomplétude qu'un assistant qui prépare des réponses envoyées aux clients.
L'évaluation sur jeu de référence répond à la question « le système sait-il répondre aux questions connues ? ». Le suivi en production répond à « que se passe-t-il sur les vraies questions, qu'on n'avait pas prévues ? ». On y suit :
Cela suppose de journaliser question, passages récupérés, réponse et retour utilisateur. Ces journaux contiennent des données internes, parfois personnelles : ils restent dans le périmètre d'hébergement du RAG, avec une durée de conservation définie.
L'évaluation continue devient vraiment utile quand chaque incident nourrit le jeu de référence. Une erreur signalée en production devient une nouvelle question, avec sa réponse attendue et ses sources. Le jour où quelqu'un modifie le système, cette erreur ne peut plus revenir sans être détectée. C'est la même logique que pour les tests de sécurité décrits dans notre article sur la prompt injection dans les agents IA : chaque tentative repérée devient un cas de test.
Chez CZ Multimédia, l'évaluation n'est pas une option ajoutée après coup : le jeu de référence se construit pendant le cadrage, les indicateurs sont mesurés avant la mise en production, et le MVP livré inclut l'évaluation qualité.
Sur nos projets de RAG d'entreprise hébergé en Europe, l'évaluation suit les mêmes étapes, quel que soit le corpus :
Côté budget, CZ Multimédia démarre un POC RAG fonctionnel à partir de 2 000 € HT, en 2 à 4 semaines. Le MVP en production, à 4 000 – 8 000 € HT, inclut l'hébergement dans l'Union européenne, l'authentification et l'évaluation qualité. Les coûts récurrents d'un projet de ce type (API, hébergement, maintenance, supervision) se situent dans la fourchette de 100 à 600 € par mois que l'on annonce pour les projets d'IA en PME. Un devis qui n'inclut ni évaluation ni estimation du coût de fonctionnement est un devis incomplet.
Cette exigence de mesure vaut aussi au-delà du RAG : dès qu'un assistant documentaire alimente un agent IA qui agit dans tes outils, une réponse fausse ne reste plus une simple réponse fausse, elle devient une action.
Avant de mettre un RAG en production, et à chaque modification importante, chaque point doit avoir une réponse claire.
Le jeu de questions de référence est construit à partir de vraies questions d'utilisateurs, pas seulement de questions inventées ou générées
Chaque question a une réponse attendue validée par un expert métier et les documents sources qui la justifient
Le jeu couvre les questions sans réponse dans le corpus, les questions multi-documents et le vocabulaire métier
La pertinence des documents récupérés est mesurée séparément de la qualité de la réponse
La fidélité au contexte est mesurée, y compris le respect de l'abstention quand l'information manque
L'exactitude est notée avec une grille écrite (correcte, incomplète, incorrecte) et un niveau de gravité
Le LLM-juge, s'il est utilisé, a été calibré sur un échantillon noté par un humain, avec une version de modèle figée
Le jeu est rejoué à chaque changement de modèle, de consigne, de chaîne de recherche ou de corpus, avec des seuils de non-régression écrits
Les échanges sont journalisés dans le même périmètre d'hébergement que le RAG, avec une durée de conservation définie
Chaque erreur repérée en production est ajoutée au jeu de référence
Si tu prépares un assistant documentaire, ou si tu en as déjà un en production sans savoir combien de ses réponses sont justes, on peut construire ensemble le jeu de référence et la première mesure, étage par étage. C'est la démarche qu'on applique à tous nos projets de RAG d'entreprise.
Contactez-nous — réponse sous 24 h, sans engagement.
J’aide les PME à améliorer leur site web et leurs projets digitaux pour générer plus de demandes clients.
Je vous propose un audit gratuit, rapide et sans engagement.
Sans engagement • Recommandations concrètes • Réponse sous 24h
Comparatif mi-2026 Mistral, OpenAI, Claude pour entreprise française : prix API, RGPD, Cloud Act, co...
Découvrez les tendances 2025 de l'automatisation intelligente boostée par l'IA. Analyse technique, c...
Découvrez comment développer votre propre assistant intelligent, étape par étape, avec les outils d'...
Panorama 2025 : frameworks agents [IA](/developpement-application-web-lyon/intelligence-artificielle...

Découvrez les tendances 2025 en développement web : agents IA, frameworks front-end modernes (React ...
Découvrez comment AgentBuilder d’OpenAI permet aux entreprises de concevoir des agents IA sur mesure...