Chatbot ou agent IA : que choisir pour votre PME en 2026 ?
Un chatbot répond, un agent agit. Budget de 1 à 10, risques, 6 cas d'usage PME et grille de décision...

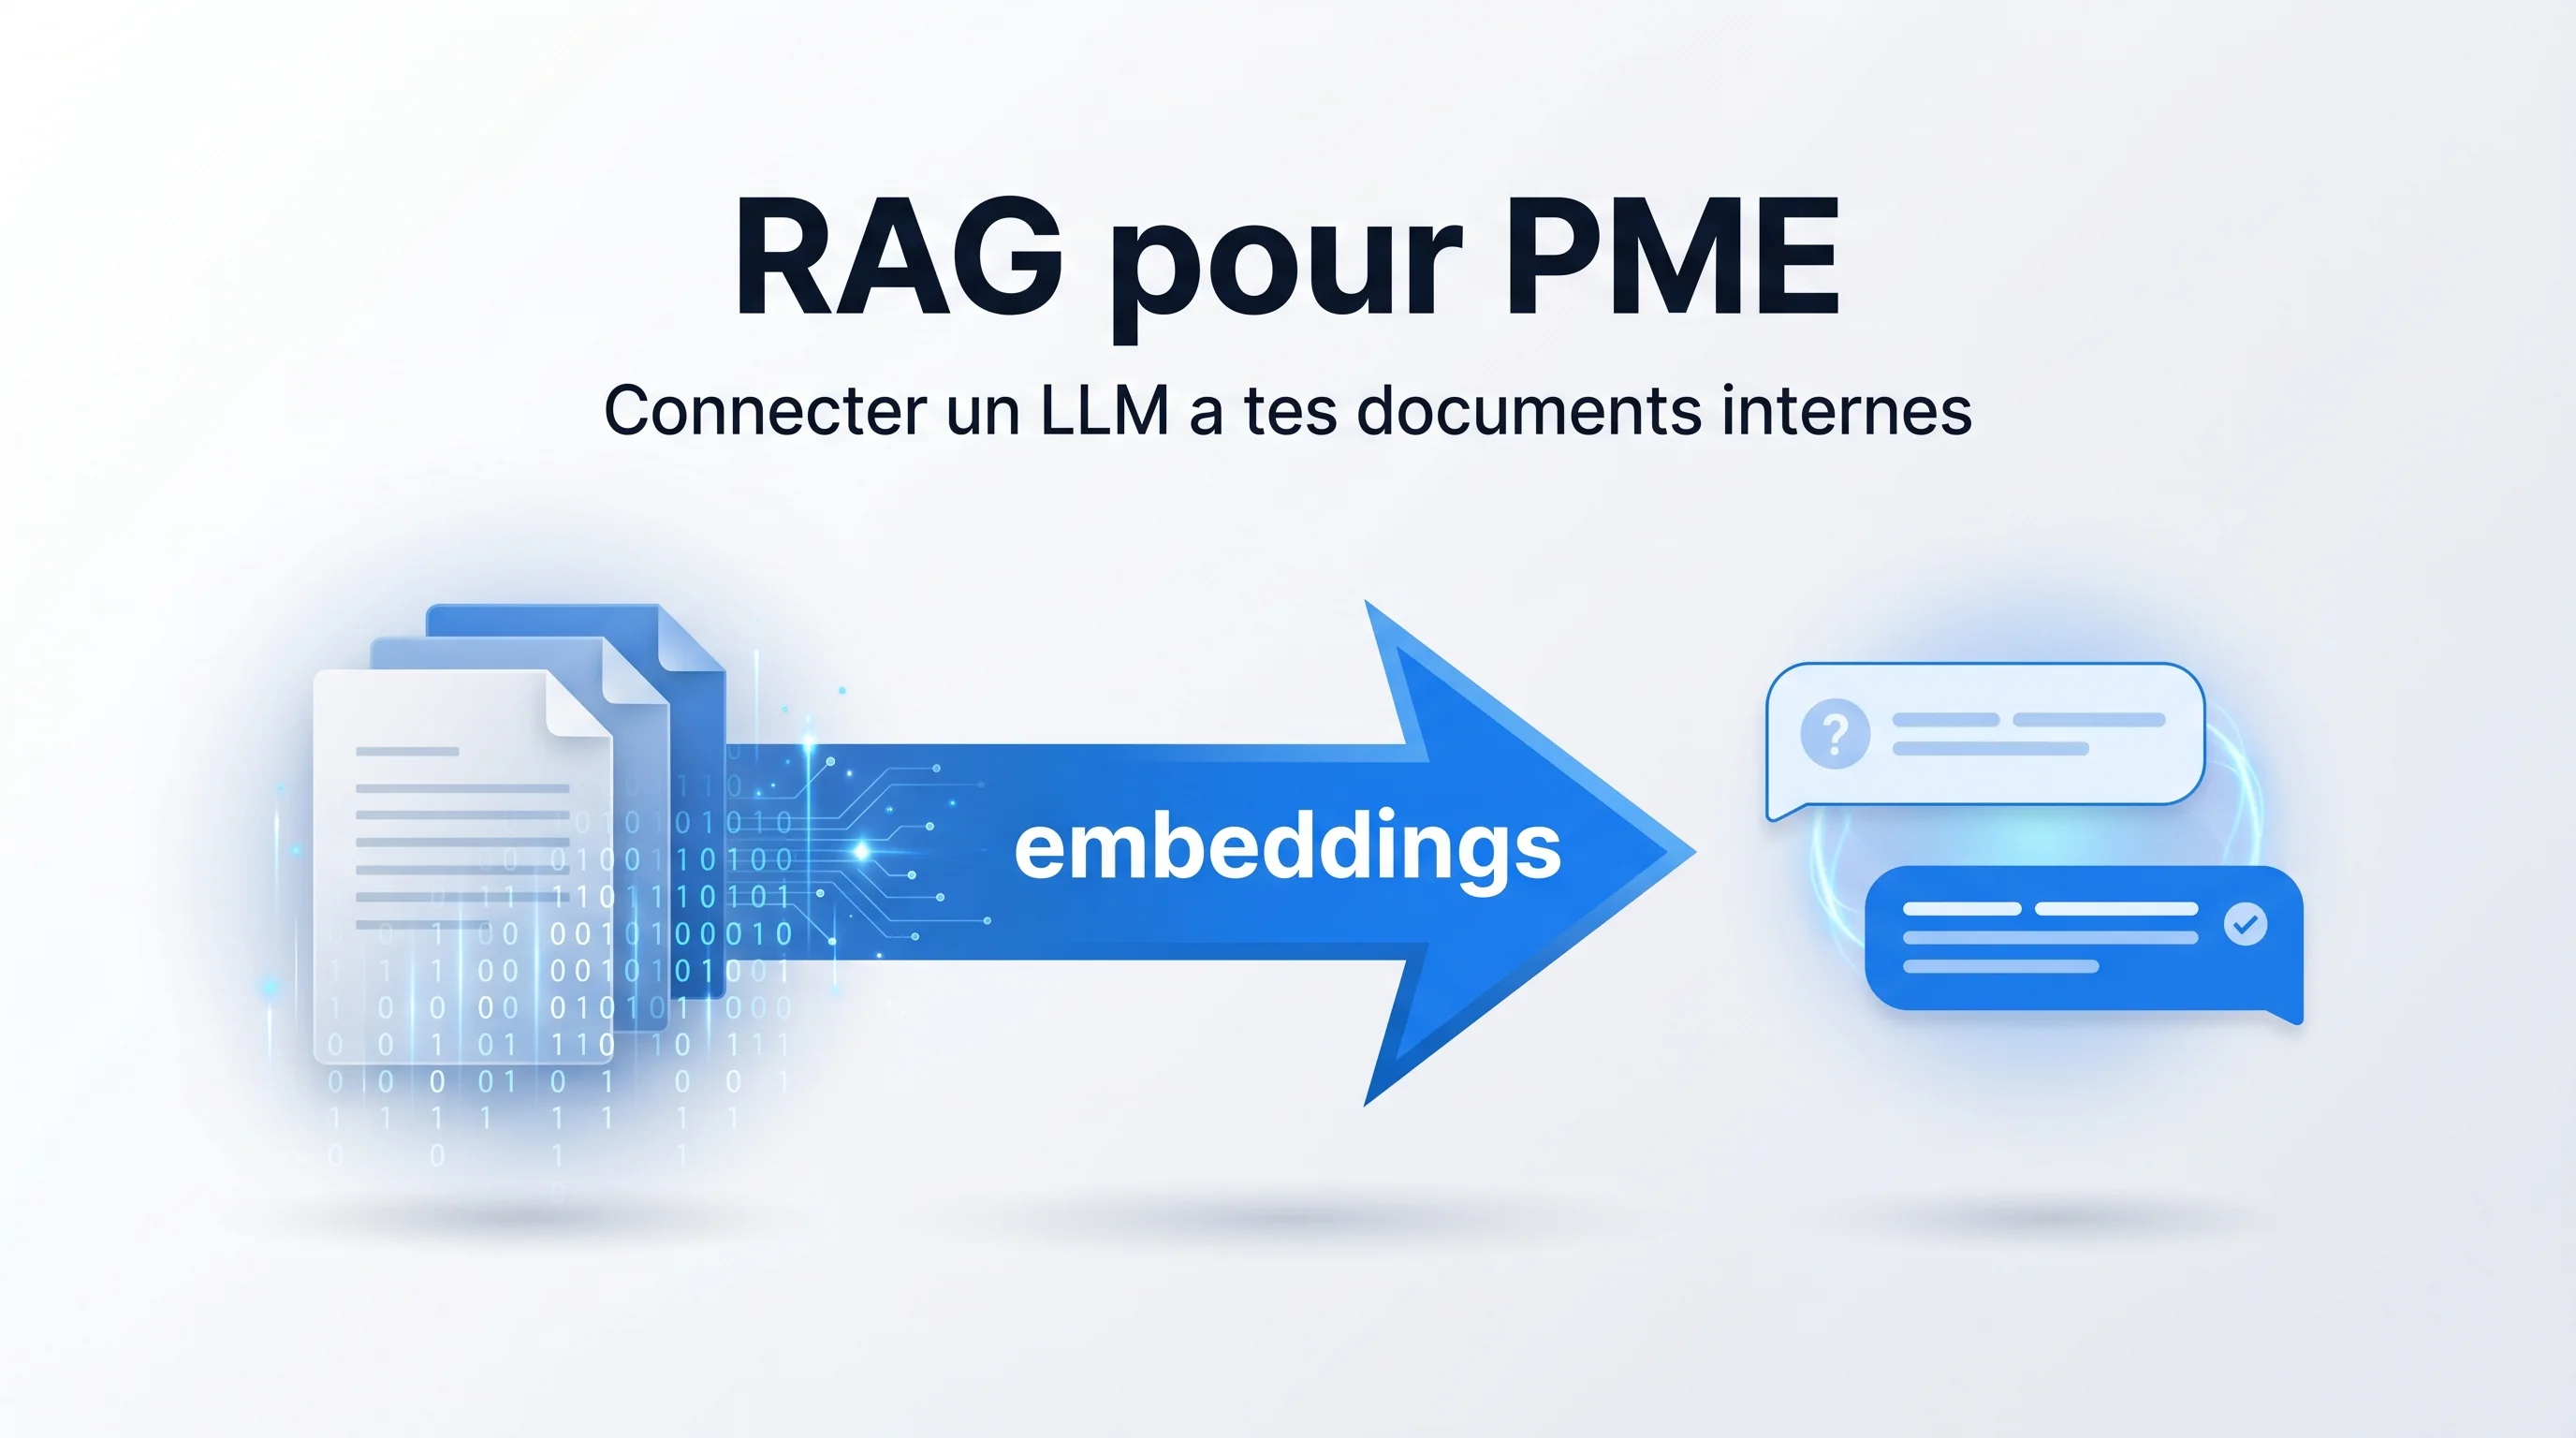
Le RAG est l'approche la plus rentable pour donner à un LLM accès à tes données internes — mais ce n'est pas une baguette magique sans qualité documentaire et bonne architecture d'embeddings.
C'est le constat qu'on fait chez CZMultimedia après avoir accompagné plusieurs PME sur des projets d'assistants IA internes. ChatGPT et Claude répondent brillamment à des questions générales, mais ils ne savent rien de ton catalogue produit, de tes procédures internes, de tes contrats, de l'historique de tes clients. Et fine-tuner un modèle sur tes données coûte cher, prend du temps, et devient obsolète à chaque mise à jour de la base documentaire.
Le RAG (Retrieval Augmented Generation) résout ce problème d'une manière simple : on récupère les bons extraits de tes documents au moment de la question, on les injecte dans le prompt, et le LLM répond en s'appuyant dessus. Pas de ré-entraînement, pas de modèle custom à maintenir. Mais pour que ça marche en production, il y a des règles d'architecture et de qualité documentaire qu'on ne peut pas ignorer.
Tu hésites entre RAG, fine-tuning ou chatbot scripté pour ton projet ? Contactez-nous
RAG signifie Retrieval Augmented Generation — littéralement "génération augmentée par la récupération". L'idée tient en une phrase : avant de répondre à une question, on cherche dans ta base documentaire les extraits les plus pertinents et on les colle dans le prompt envoyé au LLM.
L'analogie qu'on utilise souvent en réunion : c'est comme donner à un collaborateur compétent les bons documents avant qu'il rédige une réponse. Sans documents, il invente ou répond de mémoire. Avec les bons documents sous les yeux, il rédige une réponse précise, sourcée, et alignée sur ton contexte.
Quand tu poses une question à ChatGPT ou Claude sur un sujet interne à ton entreprise, trois choses peuvent se passer :
Aucune de ces situations n'est acceptable pour un assistant interne en production. Le RAG résout ça en injectant tes documents au bon moment.
Le RAG repose sur trois briques qui s'enchaînent. Voici comment ça fonctionne, sans jargon mais sans simplification abusive.
Tu prends tes documents (PDF, Word, pages Notion, articles de base de connaissance, tickets résolus, contrats…) et tu les transformes en représentation numérique exploitable par une machine. Ça se fait en trois sous-étapes :
Découpage en chunks : on coupe les documents en morceaux de 300 à 800 tokens (environ 200 à 600 mots). Trop petit, on perd le contexte. Trop grand, on noie l'information utile. Le bon réglage dépend du type de document — un contrat juridique se découpe différemment d'une FAQ produit.
Génération d'embeddings : chaque chunk passe dans un modèle d'embedding (OpenAI text-embedding-3-large, Cohere embed-v3, Voyage AI, ou un modèle open source comme bge-m3). Le modèle transforme chaque chunk en vecteur numérique de quelques milliers de dimensions. Deux textes au sens proche auront des vecteurs proches dans cet espace.
Stockage en vector database : les vecteurs et les chunks d'origine sont stockés dans une base spécialisée (pgvector, Qdrant, Pinecone, Weaviate). Cette base sait répondre vite à la question : "donne-moi les 10 vecteurs les plus proches de ce vecteur-ci".
Quand un utilisateur pose une question, voici le flux complet :
Question utilisateur
    ↓
Embedding de la question (même modèle que pour l'indexation)
    ↓
Recherche des K chunks les plus proches dans la vector DB
    ↓
Re-ranking optionnel (modèle Cohere Rerank ou cross-encoder)
    ↓
Construction du prompt : système + chunks récupérés + question
    ↓
Appel au LLM (Claude, GPT, etc.)
    ↓
Réponse générée + citations des sources
    ↓
Affichage utilisateur
L'ensemble prend généralement entre 1 et 4 secondes selon la taille du corpus, le modèle d'embedding et le LLM choisi.
La recherche vectorielle pure ramène des chunks "sémantiquement proches", mais pas toujours pertinents. Sur les projets sérieux, on ajoute systématiquement une étape de re-ranking : un modèle dédié (Cohere Rerank, ou un cross-encoder open source) ré-évalue les 50 premiers résultats et garde les 5 à 10 meilleurs.
C'est l'étape qui fait passer un RAG de "ça marche en démo" à "ça marche en production". On le constate sur tous les projets qu'on a menés : sans re-ranking, le taux de réponses pertinentes plafonne autour de 60-70%. Avec re-ranking bien réglé, on dépasse facilement les 85%.
La majorité des POC RAG qu'on voit en audit échouent pour deux raisons : un mauvais découpage en chunks (trop gros, sans recouvrement) et l'absence totale de re-ranking. Avant d'invoquer "la qualité du modèle", commence toujours par auditer ces deux points.
Le LLM (Claude, GPT-4, Gemini, Mistral) intervient uniquement à la fin. Il reçoit un prompt qui ressemble à :
Tu es l'assistant interne de [Société]. Réponds à la question
de l'utilisateur en t'appuyant uniquement sur les extraits suivants.
Si l'information n'est pas dans les extraits, dis que tu ne sais pas.
Cite les sources.

[Extrait 1] : ...
[Extrait 2] : ...
[Extrait 3] : ...

Question : [question de l'utilisateur]
Le LLM ne "sait" rien sur ton métier. Il sait juste très bien synthétiser et reformuler à partir des extraits qu'on lui donne. C'est ce qui rend le RAG portable : tu peux changer de modèle sans toucher à l'indexation.
Tu veux qu'on évalue la faisabilité d'un RAG sur ta base documentaire ? Contactez-nous
Voici un cas concret, anonymisé, qui illustre ce que le RAG change dans une PME.
Un client industriel (PME, 80 collaborateurs, secteur fabrication mécanique) avait accumulé sur 15 ans une base documentaire massive : environ 12 000 PDF (fiches techniques produits, procédures qualité, comptes-rendus de non-conformité, modes opératoires, contrats fournisseurs). Tout ça était stocké sur un serveur de fichiers, organisé selon une arborescence métier que seuls 2 ou 3 anciens collaborateurs maîtrisaient vraiment.
Le problème quotidien : les nouveaux entrants — et même les anciens — passaient un temps considérable à chercher la bonne procédure, la bonne fiche produit, la bonne version d'un document. L'équipe support technique était sollicitée plusieurs fois par jour pour des questions dont la réponse existait déjà dans un PDF, quelque part.
Avant de partir sur du RAG, on a fait un audit du corpus. Les constats :
Ce diagnostic est crucial. Sans cette phase, on aurait construit un RAG performant qui aurait répondu avec confiance en s'appuyant sur des documents périmés. Catastrophe garantie.
Sur 3 semaines (1 développeur senior + 0,5 ETP côté client pour le tri documentaire) :
Semaine 1 — Préparation du corpus
Semaine 2 — Indexation et recherche
Semaine 3 — UI, sécurité, recette
Mesurés sur les 6 premières semaines après mise en production :
Budget total du projet : environ 15 000 euros HT, dont :
Soit environ 160 euros/mois en coûts récurrents, pour un gain de 6 heures/semaine sur du temps senior. Le ROI est atteint en moins de 4 mois.
Avant d'attaquer la stack technique, audite la qualité du corpus. Un RAG sur 12 000 documents propres est plus utile qu'un RAG sur 50 000 documents truffés de doublons et de versions obsolètes.
Pour aller plus loin sur l'optimisation des temps de réponse et l'expérience utilisateur, c'est un sujet qu'on traite aussi dans notre article sur l'amélioration des performances des sites web, avec des leviers qui se cumulent côté front.
Le RAG n'est pas une solution universelle. Voici une grille honnête pour évaluer son intérêt dans ton contexte.
| Critère | Pourquoi |
|---|---|
| Tu as une base documentaire de quelques centaines à plusieurs millions de pages | Au-delà de la fenêtre de contexte d'un LLM, le RAG devient nécessaire |
| Tes documents évoluent régulièrement | L'indexation peut se mettre à jour en continu, contrairement au fine-tuning |
| Tu veux des réponses sourcées | Le RAG cite les documents utilisés, c'est traçable et vérifiable |
| Tes questions sont ouvertes (pas un parcours fermé) | Un chatbot scripté ne suffit plus, il faut de la génération |
| Tu as besoin de précision métier sans inventer | Le prompt système peut imposer "je ne sais pas" si l'info n'est pas dans les extraits |
| Tu veux pouvoir changer de LLM | Le RAG est agnostique du modèle, seul le coût/qualité compte |
| Critère | Alternative |
|---|---|
| Tu as moins de 50 documents | Injection directe en contexte du LLM (suffisant jusqu'à ~200k tokens) |
| Tes questions suivent un arbre de décision strict | Chatbot scripté classique, plus rapide, plus prévisible |
| Ton corpus n'est pas trié | Commence par nettoyer avant d'investir en RAG |
| Tu cherches des chiffres exacts dans des bases structurées | Préfère un agent SQL ou une intégration BDD via MCP |
| Tu n'as aucun référent métier pour valider les réponses | Sans validation humaine régulière, le RAG dérive sans qu'on s'en aperçoive |
Si tu observes que tes équipes passent plus de 30 minutes par jour à chercher dans la documentation interne, et que tes outils de recherche actuels ne renvoient que des listes de fichiers à parcourir, c'est le moment. C'est le pain point qu'on retrouve sur la majorité des projets qu'on a menés.
Tout vendre en RAG est une erreur. Voici les cas où on recommande autre chose.
Le RAG classique récupère 5 à 10 chunks. Si la réponse nécessite de croiser des informations dispersées dans des dizaines de documents (synthèse de jurisprudence, analyse comparative de fournisseurs sur 50 contrats), une recherche sémantique simple ne suffit plus. Il faut alors basculer sur des architectures plus avancées : RAG agentique, où un agent IA fait plusieurs requêtes successives, ou GraphRAG, qui exploite les relations entre entités.
Le RAG est conçu pour du texte non structuré. Si tu veux qu'un assistant réponde à "quel est le chiffre d'affaires de mon top 3 clients sur Q1 2026 ?", la bonne réponse n'est pas un RAG : c'est un agent capable d'écrire et d'exécuter des requêtes SQL sur ta base de données. C'est exactement le type d'usage que des protocoles comme MCP facilitent côté outils métier.
Sur des corpus très techniques (médical, juridique, ingénierie spécialisée), les embeddings génériques ratent parfois la nuance sémantique. Deux solutions : utiliser un modèle d'embedding spécialisé (il en existe pour le médical, le juridique), ou compléter par du fine-tuning ciblé sur le modèle d'embedding (pas sur le LLM).
Si ta donnée change à la seconde (cours de bourse, stock en temps réel, statut d'une commande), indexer en RAG n'a pas de sens. Tu connectes l'IA directement à l'API en temps réel, via un agent ou un workflow d'automatisation.
Croire que le RAG va corriger une mauvaise base documentaire. Si tes documents sont contradictoires, périmés ou mal nommés, le RAG va répondre avec assurance sur la base de cette mauvaise donnée. Garbage in, garbage out — règle non négociable.
On donne ici les ordres de grandeur qu'on observe sur les projets qu'on mène. Ce sont des fourchettes indicatives, à ajuster selon ton corpus.
Pour un corpus de 10 000 documents (~5 millions de tokens) :
Une requête typique consomme :
Pour 1 000 requêtes par mois, on est autour de 30 à 60 euros par mois en coûts variables. Pour une PME, c'est négligeable face au gain de temps.
Voici ce qu'on déploie par défaut, à adapter au contexte :
Vector database :
Modèle d'embedding :
Re-ranking :
LLM générateur :
Orchestration :
| Phase | Durée | Budget |
|---|---|---|
| Audit corpus + cadrage | 3-5 jours | 3 000 - 5 000 euros |
| POC sur sous-corpus | 5-10 jours | 5 000 - 10 000 euros |
| Mise en production complète | 3-6 semaines | 15 000 - 30 000 euros |
| Coûts récurrents mensuels | continu | 100 - 300 euros / mois |
Sur les projets qu'on a livrés, le ROI se mesure généralement entre 3 et 9 mois selon le volume d'utilisation.
Avant de lancer un projet RAG, vérifie ces points. Si tu coches moins de 6 items sur 9, retourne d'abord traiter les prérequis.
Tu as identifié un cas d'usage précis (assistant support, recherche réglementaire, onboarding...) — pas juste "on veut faire du RAG"
Tu connais le volume approximatif de ton corpus (nombre de documents, taille moyenne) et son taux de mise à jour
Tu as identifié un référent métier capable de valider la pertinence des réponses sur un échantillon de questions réelles
Tu as audité ton corpus : doublons, documents périmés, scans non océrisés, métadonnées manquantes
Tu as défini les questions interdites ou sensibles (données RH, juridique, financières non publiques) et la stratégie associée
Tu as un plan de gouvernance : qui ajoute des documents, qui les retire, qui valide les versions
Tu as choisi ta stratégie de souveraineté (cloud public OK ou self-hosted obligatoire ?)
Tu as un budget réaliste (15-30k pour une mise en production sérieuse, pas 2k pour un script weekend)
Tu as prévu une phase d'évaluation continue post-mise en production (logs des requêtes, échantillonnage hebdo)
Tu veux mettre un RAG en place sur tes propres documents, heberge en France ? Voir notre offre assistant RAG d'entreprise : architecture souveraine, sources citees, et ce que ca coute reellement.
Le RAG n'est pas une innovation magique. C'est une architecture pragmatique qui résout un problème concret : connecter un LLM à tes données internes sans investir dans un modèle custom.
Ce qu'il faut retenir :
Chez CZMultimedia, on accompagne les PME de la région lyonnaise et au-delà sur des projets d'automatisation et d'assistants IA basés sur le RAG. Voir notre offre intelligence artificielle à Lyon pour le détail des prestations RAG, chatbot interne et agents IA. De l'audit du corpus à la mise en production, en passant par la formation des équipes pour entretenir la base dans la durée.
Contactez-nous pour qu'on évalue ensemble si le RAG est le bon levier pour ton projet — réponse sous 24h, sans engagement.
J’aide les PME à améliorer leur site web et leurs projets digitaux pour générer plus de demandes clients.
Je vous propose un audit gratuit, rapide et sans engagement.
Sans engagement • Recommandations concrètes • Réponse sous 24h
Un chatbot répond, un agent agit. Budget de 1 à 10, risques, 6 cas d'usage PME et grille de décision...
Guide complet pour créer un chatbot IA d'entreprise : types de chatbots, budget, erreurs à éviter, c...

Prix d'un agent IA sur mesure en 2026 : 4 niveaux de 2 000 € à plus de 80 000 €, coûts récurrents, o...

Fine-tuning, RAG ou prompt engineering ? Tableau de décision, coûts réels, cas terrain. 90% du temps...
7 cas d'usage d'agent IA en entreprise avec budget réel : tri de documents, qualification, RAG, repo...
Un agent IA n8n choisit lui-même ses outils. Architecture, briques nécessaires, garde-fous, coûts ré...